二十、jQuery
jQuery下载地址:点击此处
下载教程:jQuery的下载教程
1.jQuery的介绍
jQuery 定义
jQuery 是对 JavaScript 的封装,它是免费、开源的 Javascript 函数库,jQuery 极大简化了 Javascript 编程
jQuery 作用
jQuery 和 Javascript 它们的作用一样,都是负责网页行为操作,增加网页和用户的交互效果的,只不过 jQuery 简化了Javascript 编程,jQuery 实现交互效果更简单
jQuery 优点
- jQuery 兼容了现在主流的浏览器,增加了程序员的开发效率
- jQuery 简化了 Javascript 编程,代码编写更加简单
2. jQuery的用法
jQuery的引入
<script src='./jquery-1.12.4.min.js'></script>
jQuery的入口函数
is获取标签元素,需要页面加载完成以后再获取,我们通过给onload事件属性设置了一个函数来获取标签元素,而 jQuery 提供了ready函数来解决这个问题,保证获取标签元素没有问题,它的速度比原生的window.onload更快。
入口函数代码示例:
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <!-- 导入jQuery文件 -->
    <script src='./jquery-1.12.4.min.js'></script>
    <script>
        // 原生js写法
        window.onload = function() {
            var oDiv = document.getElementById("div1");
            alert(oDiv);
        }
        // $就是jQuery的象征,$本质上是一个函数,只不过这个函数名就叫($)
        $(document).ready(function(){
            // 使用jQuery时,变量名都要以$开头,表示这是一个jQuery对象
            var $div = $("#div1");
            alert($div);
        })
    </script>
</head>
<body>
    <div id="div1">页面测试</div>
</body>
</html>
注:ready等待页面标签加载完成以后就执行ready事件,不会等待资源数据加载完成
入口函数简写代码示例:
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <!-- 导入jQuery文件 -->
    <script src='./jquery-1.12.4.min.js'></script>
    <script>
        $(function(){
            var $div = $("#div1");
            alert($div);
        })
    </script>
</head>
<body>
    <div id="div1">页面测试</div>
</body>
</html>
3. jQuery选择器
jQuery选择器的介绍
jQuery选择器就是快速选中标签元素,获取标签的,选择规则和css样式一样
jQuery选择器的种类
- 标签选择器
- 类选择器
- id选择器
- 层级选择器
- 属性选择器
示例:
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <script src="./jquery-1.12.4.min.js"></script>
    <script>
        $(function(){
            // 标签选择器
            var $p = $("p");
            alert($p.length);
            // 通过jQuery设置标签样式
            $p.css("color","red");

            // 类选择器
            var $div1 = $(".div1");
            alert($div1.length);

            // id选择器
            var $div2 = $("#div2");
            alert($div2.length);

            // 层级选择器
            var $h1 = $("div h1");
            alert($h1.length);

            // 属性选择器
            var $input = $("input[type='text']");
            alert($input.length);
        })
    </script>
</head>
<body>
    <p>哈哈哈</p>
    <p>测试</p>
    <div class="div1">我没招了</div>
    <div id="div2">我有招了</div>
    <div>
        <h1>
            你好,jQuery
        </h1>
    </div>

    <input type="text">
    <input type="button">
</body>
</html>
注:可以使用length属性来判断标签是否选择成功,如果length大于0表示成功,否则表示失败
$(function(){
    result = $("#div1").length;
    alert(result);
})
4.选择集过滤
选择集过滤的介绍
选择集过滤就是在选择标签的集合里面过滤自己需要的标签
选择集过滤的操作
has(选择器名称):表示选去包含指定选择器的标签eq(索引):表示选去指定索引的标签
示例:
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <script src="./jquery-1.12.4.min.js"></script>
    <script>
        $(function(){
            // has方法
            var $divs = $('div').has('.box');
            $divs.css('border','2px solid blue');
            // eq方法
            var $div = $('div').eq(1);
            $div.css('border','2px solid red');
        })
    </script>
</head>
<body>
    <div>
        <input type="text" class='box'>
    </div>
    <div>
        <input type="text">
        <input type="button" value="提交">
    </div>
</body>
</html>
5.选择集转移
选择集转移介绍
选择集转移就是以选择的标签为参照,然后获取转移后的标签
选择集转移操作
$(‘#box’).prev();:表示选择id是box元素的上一个的同级元素$(‘#box’).prevAll();:表示选择id是box元素的上面所有的同级元素$(‘#box’).next();:表示选择id是box元素的下一个同级元素$(‘#box’).nexrAll();:表示选择id的box元素的下面所有的同级元素$(‘#box’).parent();:表示选择id是box元素的父元素$(‘#box’).children();:表示选择id是box元素的所有子元素$(‘#box’).siblings();:表示选择id是box元素的其他同级元素$(‘#box’).find(‘.myClass’);:表示选择id是box元素的class等于myClass的元素
示例:
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <!-- 选择集转移:根据指定标签为参照物,选中其他标签 -->
    <script src="./jquery-1.12.4.min.js"></script>
    <script>
        $(function(){
            // prev:选择同级上一个
            var $prev = $('#box1').prev();
            $prev.css({
                'color':'red'
            });
            // prevAll:选择同级上方所有
            var $prevAll = $('#box1').prevAll();
            $prevAll.css({
                'border':'2px solid blue'
            });
            // next:选择同级下一个
            var $next = $('#box1').next();
            $next.css({
                'backgroundColor':'yellow'
            });
            // nextAll:选择同级下方所有
            var $nextAll = $('#box1').nextAll();
            $nextAll.css({
                'fontSize':'20px'
            });
            // parent:选择父元素
            var $parent = $('.box2').parent();
            $parent.css({
                'backgroundColor':'pink'
            });
            // children:选择所有子元素
            var $children = $('#box1').children();
            $children.css({
                'color':'blue'
            });
            // siblings:选择所有同级元素不包括自己
            var $siblings = $('.box3').siblings();
            $siblings.css({
                'fontSize':'24px'
            });
            // find:选择box1的所有同级元素中class为box2的元素
            var $find = $('#box1').find('.box2');
            $find.css({
                'backgroundColor':'green'
            });
        });
    </script>
</head>
<body>
    <p>没招了</p>
    <h3>三级标题</h3>
    <div id="box1">
        <div>第一</div>
        <div class="box2">第二</div>
        <div class="box3">第三</div>
        <div>第四</div>
        <div class="box2">第五</div>
    </div>
    <a href="">百度</a>
    <h5>五级标题</h5>
</body>
</html>
6.获取和设置元素内容
.html()方法的使用
jQuery中的.html()方法可以获取和设置标签的HTML内容
示例:
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <script src="./jquery-1.12.4.min.js"></script>
    <script>
        $(function(){
            var $div = $('div');
            // jQuery 修改 div 的内容为 Hello World
            $div.html('<a href="https://www.baidu.com">百度</a>');
            // 拓展,追加内容
            $div.append('<span>你想干嘛</span>')
        })
    </script>
</head>
<body>
    <div>哈哈</div>
    <p>测试页面</p>
</body>
</html>
7.获取和设置元素属性
prop方法使用
之前使用css方法可以给标签设置样式属性,那么设置标签的其他属性可以使用prop方法了
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <style>
        .box {
            background: lightcoral;
        }
    </style>
    <script src="./jquery-1.12.4.min.js"></script>
    <script>
        $(function(){
            var $box = $('div');
            // 获取样式属性
            var $boxsize = $box.css('font-size');
            alert($boxsize);
            // 设置样式属性
            $box.prop({
                'style': 'width: 200px; height: 200px; border: 5px solid black;',
                'class': 'box'
            })
            // 除了样式属性的相关操作使用css方法,其他都使用prop方法
            var $txt1 = $('#txt1');
            alert($txt1.prop('name'));
            // 设置属性
            $txt1.prop({
                'type':'button',
                'value':'按钮'
            });

            // 获取value属性可以使用val方法
            alert($txt1.val());
            // 使用val方法设置value属性
            $txt1.val('提交');
        })
    </script>
</head>
<body>
    <div>Test Box</div>
    <input type="text" name="username" id='txt1'>
</body>
</html>
注:获取value属性和设置value属性还可以通过**val方法**来完成
8. jQuery事件
常用事件
click():单击鼠标blur():元素失去焦点focus():元素获得焦点mouseover():鼠标进入(进入子元素也触发)mouseout():鼠标离开(离开子元素也触发)ready():DOM加载完成
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <script src="./jquery-1.12.4.min.js"></script>
    <script>
        $(function(){
            var $lis = $('ul li');
            var $buttnon1 = $('#button1');
            var $text1 = $('#text1');
            var $box = $('.box')
            // 点击
            $lis.click(function(){
                // 原生js写法
                // this.style.color = 'red';
                // jQuery写法
                $(this).css({
                    'color':'red'
                });
                // 获取点击标签的索引
                // alert($(this).index());
            });
            // 点击提交按钮,获取输入框的值
            $buttnon1.click(function(){
                alert($text1.val());
            });
            // 给输入框获得焦点
            $text1.focus(function(){
                // 获取得到焦点的文本框,然后设置样式属性
                $(this).css({
                    'background':'red'
                });
            });
            // 输入框失去焦点
            $text1.blur(function(){
                $(this).css({
                    'background':'white'
                });
            });
            // 鼠标进入
            $box.mouseover(function(){
                $(this).css({
                    'background':'red'
                });
            });
            // 鼠标离开
            $box.mouseout(function(){
                $(this).css({
                    'background':'black'
                });
            });
        });
    </script>
</head>
<body>
    <ul>
        <li>香蕉</li>
        <li>菠萝</li>
        <li>哈密瓜</li>
    </ul>
    <input type="text" id="text1">
    <input type="button" id="button1" value="按钮">
    <div class="box" style="width: 200px;height:200px;background:black;"></div>
</body>
</html>
9.事件代理
事件代理介绍
事件代理就是利用事件冒泡的原理(事件冒泡就是事件会向它的父级一级一级传递),把事件加到父级上,通过判断事件来源,执行相应的子元素的操作,事件代理首先可以极大减少事件绑定次数,提高性能;其次可以让新加入的子元素也可以拥有相同的操作。
示例:
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <script src="./jquery-1.12.4.min.js"></script>
    <!-- 事件冒泡:就是事件会一级一级往上(父控件)传递 -->
    <script>
        $(function(){
            // 获取标签
            var $btn = $('#btn1');
            var $div = $('div');
            $btn.click(function(){
                alert('我是提交');
                // 扩展:取消事件冒泡,就是不让事件向父控件传递
                // 默认是事件进行冒泡
                return false;
            });
            $div.click(function(){
                alert('我是div');
            });
        });
    </script>
</head>
<body>
    <div>
        <p id="p1">哈哈哈</p>
        <input type="button" value="提交" id="btn1">
    </div>
</body>
</html>
事件代理的使用
delegate方法使用
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <script src="./jquery-1.12.4.min.js"></script>
    <script>
        $(function(){
            var $list = $('#list');
            var $box = $('.box');
            $list.delegate('li','click',function(){
                $(this).css({'color':'red'});
            });
            // 扩展:可以代理不同子控件的事件
            // 可以代理不同子控件的事件,多个选择器用逗号隔开即可
            $box.delegate('p,input','click',function(){
                $(this).css({'color':'red'});
            });
        });
    </script>
</head>
<body>
    <ul id="list">
        <li>第一</li>
        <li>第二</li>
        <li>第三</li>
        <li>第四</li>
    </ul>
    <div class="box">
        <p>哈哈哈哈</p>
        <input type="button" value="提交">
    </div>
</body>
</html>
10.JavaScript对象
JavaScript对象的介绍
JavaScript 中的所有事物都是对象:字符串、数值、数组、函数等都可以认为是对象,此外,JavaScript 允许自定义对象,对象可以拥有属性和方法。
JavaScript创建对象操作
创建定义 JavaScript 对象有两种方式
- 通过顶级 Object 类型来实例化一个对象
- 通过对象字面量创建一个对象
Object 类创建对象示例:
var oPerson = new Object();
// 添加属性
oPerson.name = '李四';
oPerson.age = 32;

// 添加方法
oPerson.show = function(){
    alert(oPerson.name + '是gay!');
};
// 通过对象获取属性和调用方法
alert(oPerson.name)
oPerson.show()
字面量创建对象示例:
var oStudent = {
    name:'李四',
    age:35,
    show:function(){
        alert(oStudent.name +'是个gay!');
    }
};
// 调用
alert(oStudent.name+oStudent.age);
oStudent.show();
11.json
json的介绍
json是 JavaScript Object Notation 的首字母缩写,翻译过来就是 javascrip t对象表示法,这里说的 json 就是类似于 javascript 对象的字符串,它同时是一种数据格式,目前这种数据格式比较流行,逐渐替换掉了传统的xml数据格式。
json的格式
json有两种格式:
-
对象格式
对象格式的 json 数据,使用一对大括号(
{}),大括号里面放入key:value形式的键值对,多个键值对用“,”分隔{ "name":"tom", "age":18 }格式说明:json 中的(key)属性名称和字符串值需要用双引号引起来,用单引号或者不用引号,会导致读取数据错误。
-
数组格式
数组格式的 json 数据,使用一对中括号(
[]),中括号里面的数据使用逗号分隔。["tom",18,"programmer"]
实际开发的 json 格式比较复杂,例如:
{
    "name":"tom",
    "age":18,
    "hobby":["reading","travel"]
    "school":{
    	"name":'Merrimack College',
    	"location":"Nort Andover,MA"
	}
}
json 数据转换成 JavaScript 对象
json 本质上是字符串,如果在 js 中操作 json 数据,可以将 json 字符串转化为 JavaScript 对象
示例:
// 对象格式的json数据
var sJson1 = '{"name":"李四","age":23}';
// 把json数据转成JavaScript对象
var oJson = JSON.parse(sJson1);
console.log(oJson);
// 获取属性数据
console.log('我叫'+ oJson.name + ',今年'+ oJson.age+'岁!');

var sJson2 = '[{"name":"李四","age":23},{"name":"张三","age":25}]';
var oJson1 = JSON.parse(sJson2);
var aArrey = oJson1[1];
console.log('我叫'+ aArrey.name + ',今年'+ aArrey.age+'岁!');
注:
- 服务器把 json 数据给浏览器,当 js 解析数据的时候为了方便,把 json 数据解析成一个 JavaScript 对象
- 扩展:浏览器给Python服务器的json数据,Python服务器程序可以解析成字典或列表
12.ajax
ajax的介绍
ajax 是 Asynchronous JavaScript and XML的简写,ajax 一个前后台配合的技术,它可以让 javascript 发送异步的 http 请求,与后台通信进行数据的获取,ajax 最大的优点是实现局部刷新,ajax 可以发送htp请求,当获取到后台数据的时候更新页面显示数据实现局部刷新,在这里大家只需要记住,当前端页面想和后台服务器进行数据交互就可以使用 aiax 了
注:在html页面使用 ajax 需要在web服务器环境下运行,一般向自己的web服务器发送 ajax 请求。
ajax的使用
jQuery 将他封装成了一个方法$.ajax(),我们可以直接使用这个方法来执行 ajax 请求
示例:
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <script src="./jquery-1.12.4.min.js"></script>
    <script>
        // 向web服务器发送ajax请求,本质上是一个http协议的请求
        $.ajax({
            // 请求的资源地址,不指定ip地址和端口号,表示请求的是自己的服务器资源数据
            url:"测试.json",
            // 请求方式
            type:"GET",
            // 指定对服务器数据的解析格式
            dataType:'JSON',
            // data:表示发送给web服务器的参数
            data:{"name":"ls"},
            // 请求成功执行的函数
            success:function(data){
                console.log(data);
                // 数据请求回来以后可以绑定给html中的某个标签控件,实现局部刷新
            },
            // 请求失败执行的函数
            error:function(){
                alert('请求失败');
            },
            // 是否使用异步,默认不指定表示的是异步请求
            async:true
        });
    </script>
</head>
<body>

</body>
</html>
ajax 方法的参数说明
url:请求地址type:请求方式,默认是GET,常用的还有POSTdataType:设置返回的数据格式,常用的是json格式data:设置发送给服务器的数据,没有参数不需要设置success:设置请求成功后回调的函数error:设置请求失败后回调的函数async:设置是否异步,默认是true,表示异步,一般不用写- 同步和异步说明
- 同步是一个 ajax 请求完成另外一个才可以请求,需要等待上一个 ajax 请求完成,好比线程同步
- 异步是多个 ajax 同时请求,不需要等待其他 ajax 请求完成,好比线程异步
ajax 的简写方式:
$.ajax按照请求方式可以简写成$.get或者$.post方式
示例:
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <script src="./jquery-1.12.4.min.js"></script>
    <script>
        // 发送GET方式的ajax请求的简写
        // 1.请求地址
        // 2.请求传给web服务器的参数
        // 3.请求成功的回调参数
        // 4.返回数据的解析方式
        // 5.请求失败的回调参数
        $.get('测试.json',{"name":"ls"},function(data){
            // 如果按照json格式解析数据,js这块可以得到一个JavaScript对象
            console.log(data.name)
        },'JSON').error(function(){
            alert('请求失败!')
        })
        // POST
        // $.post('测试.json',{"name":"ls"},function(data){
        //     // 如果按照json格式解析数据,js这块可以得到一个JavaScript对象
        //     console.log(data.name)
        // },'JSON').error(function(){
        //     alert('请求失败!')
        // })
    </script>
</head>
<body>

</body>
</html>
ajax使用法术post请求
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
    <script src="./jquery-1.12.4.min.js"></script>
    <script>
        // POST
        // 这里没有指定http协议和ip地址和端口号,那么ajax请求会自动帮我们加上
        // 如果请求的是自己的web服务器数据,可以不用加上http协议地址,请求别人服务器的数据,要加上http协议地址
        // $.post('http://localhost:8000/ajax.html',{"name":"ls"},function(data){
        $.post('data.json',{"name":"ls"},function(data){
            // 如果按照json格式解析数据,js这块可以得到一个JavaScript对象
            console.log(data.name)
        },'JSON').error(function(){
            alert('请求失败!')
        })
    </script>
</head>
<body>

</body>
</html>
二十一、MySQL数据库的基本使用
Navicat下载地址:点击此处
1.数据库
数据库的介绍
数据库就是储存和管理数据的仓库,数据按照一定的格式进行储存,用户可以对数据库中的数据进行增加、修改、删除、查询等操作
数据库的分类
-
关系型数据库
是指采用了关系模型来组织数据的数据库,简单来说,关系模型指的就是二维表格模型,好比Excel文件中的表格,强调使用表格的方式存储数据
关系型数据库中核心元素
- 数据行
- 数据列
- 数据表
- 数据库(数据表的集合)
常用的关系型数据库
- Oracle
- SQL Server
- MySQL
- SQlite(使用在手机端)
-
非关系型数据库
非关系型数据库,又称NoSQL(Not Only SQL),意为不仅仅是SQL,对NoSQL最普遍的定义是”非关系型的“,强调 Key-Values 的方式存储数据
常用的非关系型数据库
- MongoDB
- Redis
数据库的作用
数据库的作用就是储存和管理数据的,比如我们在京东网站上浏览的商品列表数据,这些数据都会储存在数据库
数据库的特点
- 持久化存储
- 读写速度极高
- 保证数据的有效性
2.关系型数据库管理系统
关系型数据库管理系统的介绍
数据库管理系统是为管理关系型数据库而设计的软件系统,如果大家想使用关系型数据库就需要安装数据库管理系统,其实就是一个应用
关系型数据库管理系统可以分为
-
关系型数据库服务端软件
主要负责管理不同的的数据库,而每个数据库里面会有一系列数据文件,数据文件是用来存储数据的,其实数据库就是一系列数据文件的集合
-
关系型数据库客户端软件
主要负责和关系型数据库服务端软件进行通信,向服务端传输数据或者从服务端获取数据
注:
- 用户操作关系型数据库客户端,实现数据库相关操作
- 关系型数据库客户端借助网络使用SQL语言和关系型数据库进行数据通信
- 关系型数据库服务端管理者不同的数据库,每个数据库都会有一系列的数据文件,数据都保存在文件里面,每个数据库可以理解成是一个文件夹
SQL的介绍
SQL是结构化查询语言,是一种用来操作RDBMS的数据库语言,也就是说通过SQL可以操作 Oracle、sql server、MySQL、sqlite 等关系型数据库
SQL的作用是实现数据库客户端和服务端之间的通信,SQL就是通信的桥梁
SQL语言主要分为:
- DQL:数据查询语言,用于对数据进行查询,如select
- DML:数据操作语言,对数据进行增加、修改、删除,如insert、update、delete
- TPL:事物处理语言,对事物进行处理,包括 begin transaction、commit、rollback
- DCL:数据控制语言,进行授权与回收,如grant、revoke
- DDL:数据定义语言,进行数据库、表的管理等。如create、drop
注:
- 对于程序员来说,重点是数据的增、删、改、查,必须熟练编写DQL、DML,能够编写DDL完成数据库、表的操作,其他操作如TPL、DCL了解即可
- SQL语言不区分大小写
3.MySQL数据库
MySQL是一个关系型数据库管理系统,在WEB 应用方面,MySQL是最好的 RDBMS(Relational DatabaseManagement System,关系数据库管理系统)应用软件,它是由瑞典MVSQL AB 公司开发,目前属于Oracle 旗下产品,MySQL是最流行的关系型数据库管理系统中的一个。
MySQL数据库的介绍
MySQL的特点
- MySQL是开源的,所以你不需要支付额外的费用
- MySQL支持大型数据库,可以处理拥有成千上万条记录的大型数据库
- MySQL使用标准的SQL数据语言形式
- MySQL可以安装在不同的操作系统,并且提供多种编程语言的操作接口,这些编程语言包括C、C++、Python、Java、Ruby等等
MySQL数据库的安装
-
MySQL数据库服务端软件的安装
在Ubuntu中打开终端,输入以下命令:
sudo apt-get install mysql-server注:目前大家使用的Ubuntu中已经安装好了MySQL服务端软件,无需再安装
ps说明:
ps查看当前系统中的进程-a表示所有用户名-u表示显示用户名-x表示显示所有执行的程序
查看MySQL服务状态
sudo service mysql status关闭MySQL服务
sudo service mysql stop开启MySQL服务
sudo service mysql start重启MySQL
sudo service mysql restartMySQL配置文件的介绍:
配置文件路径为:
/etc/mysql/mysql.conf.d/mysqld.cnf主要配置信息说明:
port表示端口号,默认为3306bind-address表示服务器绑定的ip,默认是127.0.0.1datadir表示数据库保存路径,默认为/var/bin/mysql.frm:数据表,表结构文件.ibd:数据存放的文件
log_error表示错误日志,默认为/var/log/mysql/error.log
注:如果对配置文件进行修改,需要重启MySQL数据库服务
-
MySQL数据库客户端软件的安装
客户端是程序员或者dba使用的软件,通过 socket 方式与服务端程序通信
常用的MySQL数据库客户端软件有:
-
图形化界面客户端 Navicat
-
命令行客户端 mysql
安装方式
在Ubuntu中打开终端,输入以下命令:
sudo apt-get install mysql-client说明:
- 目前大家使用的Ubuntu中已经安装好了MySQL命令行客户端软件,无需再次安装
MySQL命令的使用帮助:
mysql --helpMySQL客户端连接MySQL服务端命令
mysql -uroot -p说明:
-u表示MySQL服务端的用户名-p表示MySQL服务端的密码quit或者exit或者ctrl+d表示退出
-
4.数据类型和约束
数据类型
数据类型是指在创建表的时候为表中字段指定数据类型,只有数据符合类型要求才能存储起来,使用数据类型的原则是:够用就行,尽量使用取值范围小的,而不用大的,这样可以更多的节省存储空间
常用数据类型如下:
- 整数:
int,bit - 小数:
decimal - 字符串:
varchar,char - 日期时间:
data,time,datatime - 枚举类型:
enum
数据类型说明:
decimal表示浮点数,如decimal(5,2)表示共存5位数,小数占2位char表示固定长度的字符串,如char(3),如果填充‘ab’时会补一个空格为‘ab’,3表示字符数varchar表示可变长度字符串,如varchar(3),填充‘ab’时就会储存‘ab’,3表示字符数- 对于图片、音频、视频等文件,不存储在数据库中,而是上传到某个服务器上,然后在表中存储这个文件的保存路径
- 字符串
text表示储存大文本,当字符大于4000时推荐使用,比如技术博客
数据约束
约束是指数据在数据类型限定的基础上额外增加的要求
常见的约束如下:
- 主键
primary key:物理上储存的顺序,MySQL建议所有表的主键字段都叫id,类型为int unsigned - 非空
not null:此字段不允许填写空值 - 惟一
unique:此字段的值不允许重复 - 默认
default:当不填写字段对应的值会使用默认值,如果填写时以填写为准 - 外键
foreign key:对关系字段进行约束,当为关系字段填写值时,会到关联的表中查询此值是否存在,如果存在则填写成功,如果不存在则填写失败并抛出异常
数据类型附录表
数值类型
| 类型 | 大小 | 范围(有符号) | 范围(无符号) | 用途 |
|---|---|---|---|---|
| TINYINT | 1 Bytes | (-128,127) | (0,255) | 小整数值 |
| SMALLINT | 2 Bytes | (-32 768,32 767) | (0,65 535) | 大整数值 |
| MEDIUMINT | 3 Bytes | (-8 388 608,8 388 607) | (0,16 777 215) | 大整数值 |
| INT或INTEGER | 4 Bytes | (-2 147 483 648,2 147 483 647) | (0,4 294 967 295) | 大整数值 |
| BIGINT | 8 Bytes | (-9,223,372,036,854,775,808,9 223 372 036 854 775 807) | (0,18 446 744 073 709 551 615) | 极大整数值 |
| FLOAT | 4 Bytes | (-3.402 823 466 E+38,-1.175 494 351 E-38),0,(1.175 494 351 E-38,3.402 823 466 351 E+38) | 0,(1.175 494 351 E-38,3.402 823 466 E+38) | 单精度 浮点数值 |
| DOUBLE | 8 Bytes | (-1.797 693 134 862 315 7 E+308,-2.225 073 858 507 201 4 E-308),0,(2.225 073 858 507 201 4 E-308,1.797 693 134 862 315 7 E+308) | 0,(2.225 073 858 507 201 4 E-308,1.797 693 134 862 315 7 E+308) | 双精度 浮点数值 |
| DECIMAL | 对DECIMAL(M,D) ,如果M>D,为M+2否则为D+2 | 依赖于M和D的值 | 依赖于M和D的值 | 小数值 |
日期和时间类型
| 类型 | 大小 ( bytes) | 范围 | 格式 | 用途 |
|---|---|---|---|---|
| DATE | 3 | 1000-01-01/9999-12-31 | YYYY-MM-DD | 日期值 |
| TIME | 3 | '-838:59:59'/'838:59:59' | HH:MM:SS | 时间值或持续时间 |
| YEAR | 1 | 1901/2155 | YYYY | 年份值 |
| DATETIME | 8 | '1000-01-01 00:00:00' 到 '9999-12-31 23:59:59' | YYYY-MM-DD hh:mm:ss | 混合日期和时间值 |
| TIMESTAMP | 4 | '1970-01-01 00:00:01' UTC 到 '2038-01-19 03:14:07' UTC结束时间是第 2147483647 秒,北京时间 2038-1-19 11:14:07,格林尼治时间 2038年1月19日 凌晨 03:14:07 | YYYY-MM-DD hh:mm:ss | 混合日期和时间值,时间戳 |
字符串类型
| 类型 | 大小 | 用途 |
|---|---|---|
| CHAR | 0-255 bytes | 定长字符串 |
| VARCHAR | 0-65535 bytes | 变长字符串 |
| TINYBLOB | 0-255 bytes | 不超过 255 个字符的二进制字符串 |
| TINYTEXT | 0-255 bytes | 短文本字符串 |
| BLOB | 0-65 535 bytes | 二进制形式的长文本数据 |
| TEXT | 0-65 535 bytes | 长文本数据 |
| MEDIUMBLOB | 0-16 777 215 bytes | 二进制形式的中等长度文本数据 |
| MEDIUMTEXT | 0-16 777 215 bytes | 中等长度文本数据 |
| LONGBLOB | 0-4 294 967 295 bytes | 二进制形式的极大文本数据 |
| LONGTEXT | 0-4 294 967 295 bytes | 极大文本数据 |
枚举与集合类型
- ENUM: 枚举类型,用于存储单一值,可以选择一个预定义的集合。
- SET: 集合类型,用于存储多个值,可以选择多个预定义的集合。
空间数据类型
GEOMETRY, POINT, LINESTRING, POLYGON, MULTIPOINT, MULTILINESTRING, MULTIPOLYGON, GEOMETRYCOLLECTION: 用于存储空间数据(地理信息、几何图形等)。
5.图形化客户端Navicat
Navicat的使用
-
和MySQL数据库服务端建立连接
-
数据库的操作
新建数据库
字符集:必须指定
UTF-8编码格式(utf8 -- UTF-8 Unicode),否则出现中文就会乱码排序规则:
utf8_general_ci:通用排序规则忽略大小写,比如:查询时a和A都能被查询出来utf8_bin:区分大小写
-
数据表的操作
-
数据表中数据的操作
6.命令行客户端MySQL的使用
登录和登出数据库
登录数据库
输入下面命令:
sudo mysql -uroot -p
说明:
-u后面是登录的用户名-p后面的是登录密码,如果不填写,回车后会提示输入密码
登录成功后,输入如下命令查看效果:
显示当前时间
select now();
登出(退出)数据库:
quit或exit或ctrl+d
数据库操作的SQL语句
-
查看所有数据库
show databases; -
创建数据库
create database 数据库名 charset=utf8; -
使用数据库
use 数据库名; -
查看当前使用的数据库
select database(); -
删除数据库-慎重
drop database 数据库名;
表结构操作的SQL语句
-
查看当前数据库中所有表
show tables; -
创建表
create table students(
    id int unsigned primary key auto_increment not null,
    name varchar(10) not null,
    age tinyint default 0,
    gender enum('男','女','gay','人妖','保密') default '男');
说明:
create table 表名(
    字段名称 数据类型 可选的约束条件,
    column1 datatype contrai,
    ...
);
查看表结构
desc 表名; -
修改表-添加字段
alter table 表名 add 列名 类型 约束; # 例: alter table students add birthday datetime; -
修改表-修改字段类型
alter table 表名 modify 列名 类型 约束;
# 例:
alter table students modify birthday date not null;
说明:
modify:只能修改字段类型或者约束,不能修改字段名
-
修改表-修改字段名和字段类型
alter table 表名 change 原名 新名 类型及约束;
# 例:
alter table students change birthday birth datetime not null;
说明:
change:既能对字段重命名又能修改字段类型还能修改约束
-
修改表-删除字段
alter table 表名 drop 列名; # 例: alter table students drop birthday; -
查看创表SQL语句
show create table 表名; # 例: show create table students; -
查看创库SQL语句
show create database 数据库名; # 例: show create database python1; -
删除表
drop table 表名;
# 例:
drop table students;
表数据操作的SQL语句
-
查询数据
查询所有列
select * from 表名;
# 例:
select * from students;
查询所指定列
select 列1,列2,... from 表名; # 例: select id,name from students; -
添加数据
全列插入:值的顺序与表结构字段的顺序完全一一对应
insert into 表名 values(...); # 例: insert into students values(0,'xx',default,default,'男');部分列插入:值的顺序与给出的列顺序对应
insert into 表名 (列1,,...) values(值1,...); # 例: insert into students(name,age) values('张三',42);全列多行插入:
insert into 表名 values(...),(...)...;
# 例:
insert into students  values(0,'张飞',55,1.75,'男'),(0,'关羽',58,1.85,'男');
部分列多行插入:
insert into 表名(列1,列2,...) values(值1,值2,...);
# 例
insert into students(name,height) values('刘备',1.75),('曹操',1.6);
说明:
- 主键类是自动增长,但是在全列插入时需要占位,通常使用空值(
0或者null或者default) - 在全列插入时,如果字段列有默认值可以使用
defualt来占位,插入后的数据就是之前设置的默认值
- 主键类是自动增长,但是在全列插入时需要占位,通常使用空值(
-
修改数据
update 表名 set 列1=值1,列2=值2,... where 条件; # 例: update students set age=18,gender='女' where id=6; -
删除数据
delete from 表名 where 条件;
# 例:
delete from students where id=5;
问题:
上面的操作称之为物理删除,一旦删除就不容易恢复,我们可以使用逻辑删除的方式来解决这个问题
逻辑删除
添加删除表示字段,
0代表未删除,1代表删除# 添加一个新的字段,默认值为0 alter table students add is_del tinyint default 0; # 修改要删除字段为1 update students set is_del=1 where id=7; # 查看已删除的人 select * from students where is_del=1; # 撤销删除将1,改成0即可
总结
- 登录数据库:
mysql -uroot -p - 退出数据库:
quit或者exit或者ctrl + d - 创建数据库:
create database 数据库名 charst=utf8; - 使用数据库:
use 数据库名; - 删除数据库:
drop database 数据库名; - 创建表:
create table 表名(字段名 字段类型 约束 ,...); - 修改表-添加字段:
alter table 表名 add 字段名 字段类型 约束; - 修改表-修改字段类型:
alter table 表名 modify 字段名 字段类型 约束; - 修改表-修改字段名和字段类型:
alter table 表名 change 原字段名 新字段名 字段类型 约束; - 修改表-删除字段:
alter table 表名 drop 字段名; - 删除表:
drop table 表名; - 查询数据:
select * from 表名;或者select 列1,列2 from 表名; - 插入数据:
insert into 表名 values(....);或者insert into 表名(列1,...) values(值1,...); - 修改数据:
update 表名 set 列1=值1,列2=值2... where 条件; - 删除数据:
delete from 表名 where 条件;
7.as和distinct关键字
as关键字
在使用SQL语句显示结果的时候,往往在屏幕显示的字段名不具备良好的可读性,此时可以使用as给字段起一个别名
-
使用
as给字段起别名select id as 序号, name as 名字, age as 年龄, gender as 性别 from 表名; -
通过
as给表起别名如果是单表查询-可以省略表名
select id,name,gender from students;表.字段名select students.id,students.name from students;可以通过
as给表起别名select s.id,s.name from students as s;说明
- 在这里给表起别名,看起来并没什么意义,并不是这样的,后期学习自连接的时候,必须要对表起别名
distinct关键字
distinct可以去除重复数据行
select distinct gender from students;
多列:
select distinct age,gender from students;
8.where条件查询
where条件查询的介绍
使用where条件查询可以对表中的数据进行筛选,条件成立的记录会出现在结果集中
where语句支持的运算符
- 比较运算符
- 逻辑运算符
- 模糊查询
- 范围查询
- 空判断
where条件查询语法格式
select * from 表名 where 条件;
比较运算符
- 等于:
= - 大于:
> - 大于等于:
>= - 小于:
< - 小于等于:
<= - 不等于:
!=或<>
例:
查询编号大于3的学生
select * from students where id>3;
查询编号不大于4的学生
select * from students where id<=4;
查询姓名不是“黄蓉”的学生
select * from students where name!='黄蓉';
select * from students where name<>'黄蓉';
查询没被删的学生
select * from students where is_del=0;
逻辑运算符
andornot
例:
查询编号大于3的女同学
select * from students where id > 3 and gender='女';
查询编号小于4或没被删除的学生
select * from students where id < 4 and is_del = 0;
查询年龄不在10岁到15岁之间的学生
select * from students where not (age>=10 and age <=15);
说明:
- 多个条件判断想要作为一个整体,可以结合"
()"
模糊查询
like:是模糊查询关键字%:表示任意多个任意字符_:表示一个任意字符
例:
查询姓黄的学生
select * from students where name like '黄%';
查询姓黄且“名”是一个字的学生
select * from students where name like '黄_';
# 两个
select * from students where name like '黄__';
查询姓黄或者叫靖的学生
select * from students where name like '黄%' or name like '%靖';
范围查询
between .. and ..:表示在一个连续的范围内查询in:表示在一个非连续的范围内查询
例:
查询编号为3至8的学生
select * from students where id between 3 and 8;
查询编号不是3至8的男生
select * from students where not (id between 3 and 8);
查询编号是3、5、7的学生
select * from students where id in (3,5,7);
查询编号不是3、5、7的学生
select * from students where id not in (3,5,7);
空判断查询
- 判断为空使用:
is null - 判断非空使用:
is not null
例:
查询没有填写身高的学生
select * from students where height is null;
查询填写身高的学生
select * from students where height is not null;
注:
- 不能使用
where height = null判断为空 - 不能使用
where height != null判断非空 null不等于‘’空字符串
9.排序
排序查询语法
select * from 表名 order by 列1 asc|desc [列2 asc|desc,...];
语法说明
- 先按照列1进行排序,如果列1的值相同时,则按照列2排序,以此类推
asc:从小到大排列,即升序desc:从大到小排序,即降序- 默认按照列值从大到小,(即
asc关键字)
例:
查询未删除的男生信息,按学号排序
select * from students where gender='男' and is_del=0 order by id desc;
显示所有学生的信息,先按照年龄从大–>小排序,当年龄相同时,按照身高从高–>矮排序
select * from students order by age desc, height desc;
10.分页查询
分页查询的语法
select * from 表名 limit start,count
说明:
limit:是分页查询关键字start:表示开始行索引,默认是0count:表示查询条数
例:
查询前三行男生信息
select * from students where gender='男' limit 0,3;
# 简写
select * from students where gender='男' limit 3;
分页查询案例
已知每页显示m条数据,求第n页显示的数据
提示:关键是求每页的开始行索引
查询学生表,获取第n也数据的SQL语句:
select * from students limit (n-1)*m,n;
二十二、MySQL数据库的条件查询
MySQL清屏命令
system clear
1.聚合函数
聚合函数的介绍
聚合函数又叫组函数,通常是对表中的数据进行统计和计算,一般结合分组(group by)来使用,用于统计和计算分组数据
常用的聚合函数
count(col):表示求指定列的总行数max(col):表示求指定列的最大值min(col):表示求指定列的最小值sum(col):表示求指定列的和avg(col):表示求指定列的平均值
求总行数
返回非null的总行数
select count(height) from students;
返回总行数,包含null值记录
select count(*) from students;
注:聚合函数不会对空值进行统计,一般如果要指定列名,那么就是主键字段,通用写法使用*
求最大值
查询女生的编号最大值
select max(id) from students where gender='女';
求最小值
查询未删除学生的最小编号
select min(id) from students where is_del=0;
求和
查询男生的总身高
select sum(height) from students where gender='男';
求平均值
查询平均身高
select avg(height) from students;
查询平均身高(包含null值)
select avg(ifnull(height,0)) from students;
说明:
ifnull函数:表示判断指定字段是否为null,如果为空,使用自己提供的值
聚合函数的特点
- 聚合函数默认忽略字段为
null的记录,要想列值为null的记录也参与计算,必须使用ifnull函数对null值做替换
2.分组查询
分组函数介绍
分组查询就是将查询的结果按照指定字段进行分组,字段中数据相等的分为一组
分组查询基本语法:
GROUP BY 列名 [HAVING 条件表达式] [WITH ROLLUP]
说明:
- 列名:是指按照指定字段的值进行分组
HAVING 条件表达式:用来过滤分组后的数据WITH ROLLUP:在所有记录的最后加上记录,显示select查询时聚合函数的统计和计算结果
group by的使用
group by可以用于单个字段分组,也可以用于多个字段分组
根据gender字段来分组
select gender from students group by gender;
根据name和gender字段进行分组
select name,gender from students group by name,gender;
group by + group_concat()的使用
group_concat(字段名):统计每个分组指定字段的信息集合,每个信息之间使用逗号进行分割
根据gender字段进行分组,查询gender字段和分组的name字段信息
select gender,group_concat(name) from students group by gender;
结果:
+--------+---------------------------------------+
| gender | group_concat(name)                    |
+--------+---------------------------------------+
| 男     | 吉吉,光头强,熊大,熊二,张三			   |
| 女     | 翠花,小乔							   |
+--------+---------------------------------------+
统计不同性别的平均年龄
select gender,avg(age) from students group by gender;
统计不同性别的人的个数
select gender,count(*) from students group by gender;
根据gender字段进行分组,统计分组条条数大于2的
select gender,count(*) from students group by gender having count(*)>2;
说明:对分组数据进行过滤使用having
group by + with rollup的使用
with rollup的作用是:在最会记录后面新增一行,显示select查询时聚合函数的统计和计算结果
根据gender字段进行分组,汇总总人数
select gender,count(*) from students group by gender with rollup;
根据gender字段进行分组,汇总所有人的年龄
select gender,group_concat(age) from students group by gender with rollup;
结果:
+--------+----------------------+
| gender | group_concat(age)    |
+--------+----------------------+
| 男     | 24,44,33,27,18       |
| 女     | 21,24                |
| NULL   | 24,44,33,27,18,21,24 |
+--------+----------------------+
连接查询的介绍
连接查询可以实现多个表的查询,当查询的字段数据来自不同的表就可以使用连接查询来完成
连接查询可以分为:
- 内连接查询
- 左连接查询
- 右连接查询
- 自连接查询
3.连接查询-内连接
查询两个表中复合条件的共有记录
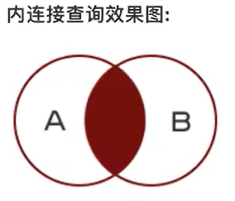
内连接查询语法:
select 字段 from 表1 inner join 表2 no 表1.字段1 = 表2.字段2;
说明:
inner join:就是内连接查询的关键字on:就是连接查询条件
例:使用内连接查询学生表与班级表
select * from students as s inner join classes as c on s.c_id = c.id;
方法二:
select s.name,c.name from students as s inner join classes as c on s.c_id = c.id;
效果:
+-----------+--------+
| name      | name   |
+-----------+--------+
| 吉吉      | python |
| 光头强    | python |
| 翠花      | java   |
| 小乔      | python |
| 熊大      | java   |
| 张三      | python |
+-----------+--------+
4.连接查询-左连接
以左表为主根据条件查询右表数据,如果根据条件查询右表数据不存在使用null值填充
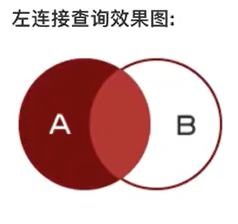
左连接查询语法格式:
select 字段 from 表1 left join 表2 on 表1.字段1=表2.字段2
说明:
left join:就是左连接查询关键字on:就是连接查询条件表1:就是左表表2:就是右表
例:使用左连接查询学生表与班级
select s.name,c.name from students as s left join classes as c on s.c_id = c.id;
结果:
+-----------+--------+
| name      | name   |
+-----------+--------+
| 吉吉      | python |
| 光头强    | python |
| 翠花      | java   |
| 小乔      | python |
| 熊大      | java   |
| 熊二      | NULL   |
| 张三      | python |
+-----------+--------+
5.连接查询-右连接
以右表为主根据条件查询左表数据,如果根据条件查询左表数据不存在使用null值填充
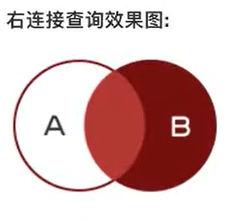
右连接查询语法格式:
select 字段 from 表1 right join 表2 on 表1.字段1=表2.字段2
说明:
right join:就是右连接查询关键字on:就是连接查询条件表1:就是左表表2:就是右表
例:使用右连接查询学生表与班级
select s.name,c.name from students as s right join classes as c on s.c_id = c.id;
结果:
+-----------+--------+
| name      | name   |
+-----------+--------+
| 张三      | python |
| 小乔      | python |
| 光头强    | python |
| 吉吉      | python |
| 熊大      | java   |
| 翠花      | java   |
| NULL      | THML   |
+-----------+--------+
6.连接查询-自连接
左表和右表是同一张表,根据连接查询条件查询两个表中的数据
创建areas表:
create table areas(id varchar(30) not null primary key, title varchar(30) not null, pid varchar(30));
执行SQL语句给areas表导入数据:
source areas.sql;
-
扩展:
areas.sql文件的制作新建文本文件,插入以下内容:
INSERT INTO `areas` VALUES ('440000', '广东省', NULL);
INSERT INTO `areas` VALUES ('440100', '广州市', '440000');
INSERT INTO `areas` VALUES ('440300', '深圳市', '440000');
INSERT INTO `areas` VALUES ('440600', '佛山市', '440000');
INSERT INTO `areas` VALUES ('440700', '江门市', '440000');
INSERT INTO `areas` VALUES ('510000', '四川省', NULL);
INSERT INTO `areas` VALUES ('510100', '成都市', '510000');
INSERT INTO `areas` VALUES ('510600', '德阳市', '510000');
INSERT INTO `areas` VALUES ('510700', '绵阳市', '510000');
INSERT INTO `areas` VALUES ('510800', '广元市', '510000');
INSERT INTO `areas` VALUES ('420000', '湖北省', NULL);
INSERT INTO `areas` VALUES ('420100', '武汉市', '420000');
INSERT INTO `areas` VALUES ('420500', '宜昌市', '420000');
INSERT INTO `areas` VALUES ('420600', '襄阳市', '420000');
INSERT INTO `areas` VALUES ('420700', '鄂州市', '420000');
INSERT INTO `areas` VALUES ('610000', '陕西省', NULL);
INSERT INTO `areas` VALUES ('610100', '西安市', '610000');
INSERT INTO `areas` VALUES ('610200', '铜川市', '610000');
INSERT INTO `areas` VALUES ('610300', '宝鸡市', '610000');
INSERT INTO `areas` VALUES ('610400', '咸阳市', '610000');
保存并退出,将后缀
.txt改为.sql,导入Ubuntu即可
查询地址属于哪个地方
select c.id,c.title,c.pid,p.title from areas as c inner join areas as p on c.pid = p.id;
结果:
+--------+-----------+--------+-----------+
| id     | title     | pid    | title     |
+--------+-----------+--------+-----------+
| 420100 | 武汉市    | 420000 | 湖北省    |
| 420500 | 宜昌市    | 420000 | 湖北省    |
| 420600 | 襄阳市    | 420000 | 湖北省    |
| 420700 | 鄂州市    | 420000 | 湖北省    |
| 440100 | 广州市    | 440000 | 广东省    |
| 440300 | 深圳市    | 440000 | 广东省    |
| 440600 | 佛山市    | 440000 | 广东省    |
| 440700 | 江门市    | 440000 | 广东省    |
| 510100 | 成都市    | 510000 | 四川省    |
| 510600 | 德阳市    | 510000 | 四川省    |
| 510700 | 绵阳市    | 510000 | 四川省    |
| 510800 | 广元市    | 510000 | 四川省    |
| 610100 | 西安市    | 610000 | 陕西省    |
| 610200 | 铜川市    | 610000 | 陕西省    |
| 610300 | 宝鸡市    | 610000 | 陕西省    |
| 610400 | 咸阳市    | 610000 | 陕西省    |
+--------+-----------+--------+-----------+
只查询湖北省:
select c.id,c.title,c.pid,p.title from areas as c inner join areas as p on c.pid = p.id where p.title='湖北省';
结果:
+--------+-----------+--------+-----------+
| id     | title     | pid    | title     |
+--------+-----------+--------+-----------+
| 420100 | 武汉市    | 420000 | 湖北省    |
| 420500 | 宜昌市    | 420000 | 湖北省    |
| 420600 | 襄阳市    | 420000 | 湖北省    |
| 420700 | 鄂州市    | 420000 | 湖北省    |
+--------+-----------+--------+-----------+
说明:自连接必须对表起别名
总结:
- 自连接查询就是把一张表模拟成左右两张表,然后进行连表查询
- 自连接就是一种特殊的连接方式,连接的表还是本身这张表
7.子查询
子查询的介绍
在一个select语句中,嵌入了另外一个select语句,那么被嵌入的select语句称之为子查询语句,外部那个select语句则称为主查询
主查询和子查询的关系:
- 子查询是嵌入到主查询中
- 子查询是辅助主查询的,要么充当条件,要么充当数据源
- 子查询是可以独立存在的语句,是一条完整的
select语句
子查询的使用
例:
查询大于平均年龄的学生
select * from students where age > (select avg(age) from students);
查询学生在班的所有班级名字
select * from classes where id in (select c_id from students where c_id is not null);
查找年龄最大,身高最高的学生
select * from students where (age, height) = (select max(age),max(height) from students);
说明:子查询是一个完整的查询语句,子查询的执行顺序,先执行子查询然后主查询根据子查询的结果再执行
扩展
客户端连接MySQL数据库
修改配置文件
vim /etc/mysql/mysql.conf.d/mysqld.cnf
找到bind-address = 127.0.0.1将其注释掉保存并退出:wq
登入MySQL数据库
mysql -uroot -p
然后
show databases;
进入名为mysql的数据库
use mysql;
show tables;
查找user表中的信息
select * from user G;
寻找User: root字段
将User: root字段前的Host改完%
update user set host = '%' where User='root';
修改完成退出MySQL
重新启动MySQL服务
sudo service mysql restart;
等待启动完成就可使用windows服务端软件Navicat连接MySQL数据库
注:如果出现以下报错
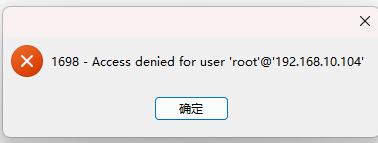
解决方法:
修改配置文件
vim /etc/mysql/mysql.conf.d/mysqld.cnf
修改后,如下:
bind-address            = 0.0.0.0
mysqlx-bind-address     = 127.0.0.1
mysqlx = 0
port = 3306
重启MySQL服务
service mysql restart
使用以下SQL命令创建或更新用户权限:
-- 先删除旧的root@%(避免冲突)
DROP USER IF EXISTS 'root'@'%';
-- 允许所有 IP
CREATE USER 'root'@'%' IDENTIFIED BY 'password';
-- 如果已存在root@特定IP,修改为允许所有IP(推荐)
ALTER USER 'root'@'%' IDENTIFIED BY 'password';
password:修改成实际的密码
授予权限:
-- 允许所有 IP
-- 授予所有权限(所有库、所有表),并允许该账号给其他用户授权
GRANT ALL PRIVILEGES ON *.* TO 'root'@'%' WITH GRANT OPTION;
刷新权限:
FLUSH PRIVILEGES;
即可解决
8.数据库设计之三范式
数据库设计之三范式的介绍
范式:对设计数据库提出一些规范,目前有迹可循的共有8种范式,一般遵循3范式即可
- 第一范式(1NF):强调的是列的原子性,即列不能够再分成其他几列
- 第二范式(2NF):满足1NF,另外包含两部分内容,一是表必须有个主键;二是非主键字段必须完全依赖于主键,而不能只依赖于主键的一部分
- 第三范式(3NF):满足2NF,另外非主键列必须直接依赖于主键,不能存在传递依赖。即不能存在非主键列A依赖于非主键列B,非主键列B依赖于主键的情况
第一范式的介绍
如图所示:
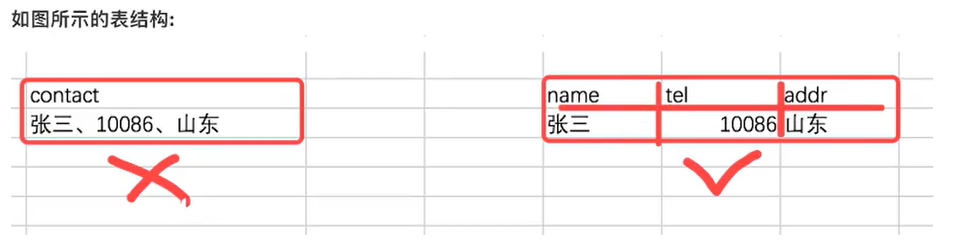
说明:
- 这种表的结果设计就没有达到1NF,要符合1NF我们只需要把列拆分,即:把
contact字段拆分成name、tel、addr等字段
第二范式的介绍
如图所示:
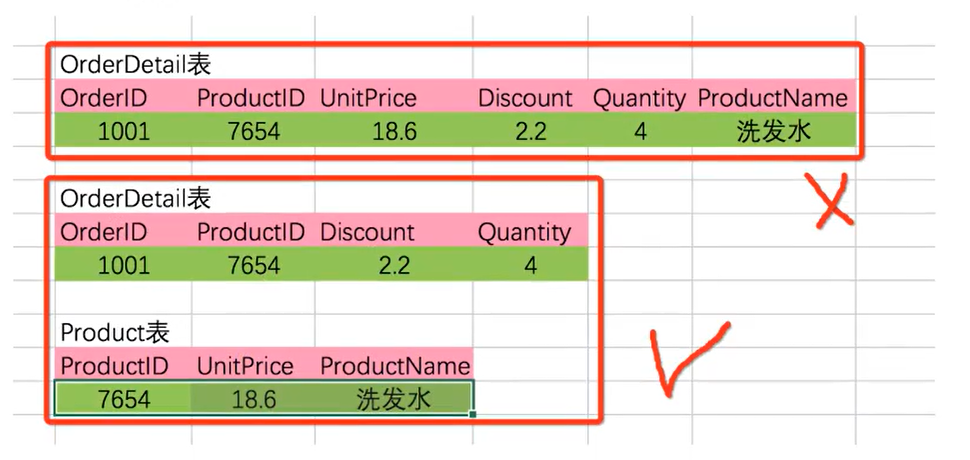
- 这种表结构设计就没有达到 2NF,因为 Discount(折扣),Quantity(数量)完全依赖于主键(OrderlD),而 UnitPrice单价,ProductName产品名称只依赖于 ProductlD,所以 OrderDetail表不符合 2NF。
- 我们可以把【OrderDetail】表拆分为【OrderDetail】(OrderlD,ProductlD,Discount,Quantity)和【Product】(ProductlD,UnitPrice,ProductName)这样就符合第二范式了。
第三范式的介绍
如图所示:
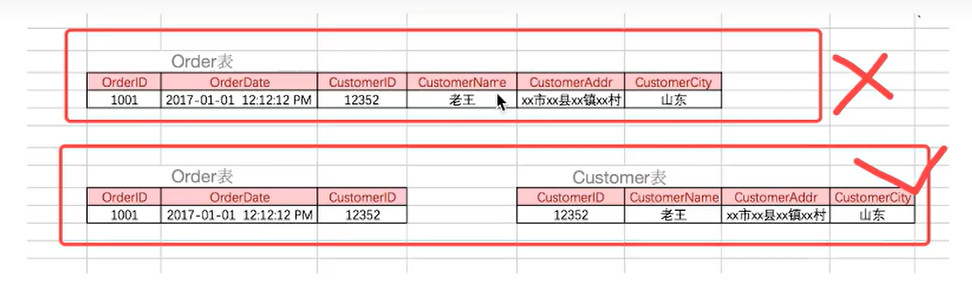
说明:
- 这种表结构设计就没有达到 3NF,因为 OrderDate,CustomerlD,CustomerNameCustomerAddr,CustomerCity 等非主键列都完全依赖于主键(OrderlD),所以符合 2NF。不过问题是 CustomerName,CustomerAddr,CustomerCity直接依赖的是 CustomerlD(非主键列),而不是直接依赖于主键,它是通过传递才依赖于主键,所以不符合 3NF。
- 我们可以把【Order】表拆分为【Order】(OrderlD,OrderDate,CustomerlD)和【Customer】(CustomerlD,CustomerName,CustomerAddr,CustomerCity)从而达到 3NF 。
E-R模型的介绍
E-R模型即实体-关系模型,E-R模型就是描述数据库存储数据的结构模型
E-R模型的使用场景
- 对于大型公司开发项目,我们需要根据产品经理的设计,我们先使用建模工具,如:
power designer、db desinger等这些软件来画出实体-关系模型(E-R模型) - 然后根据三范式设计数据库表结构
E-R模型效果图:
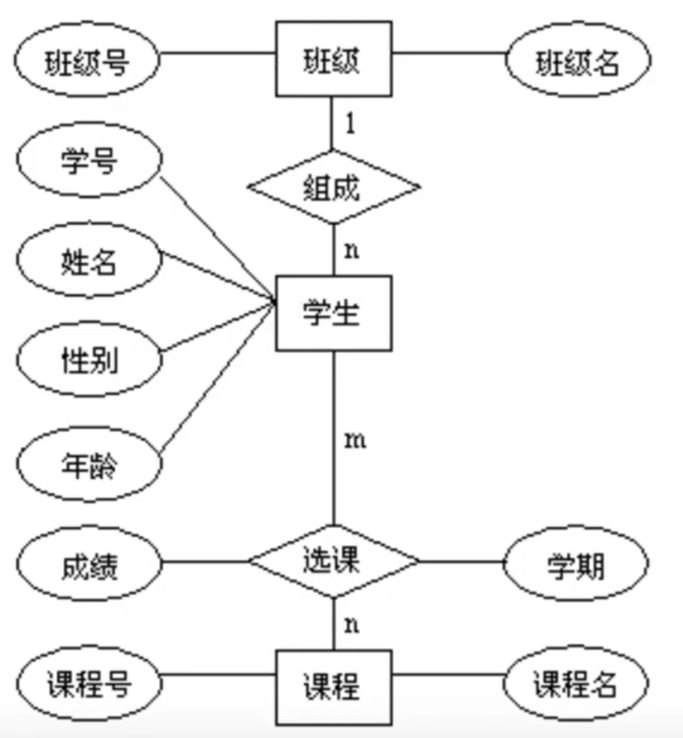
说明:
-
实体:用矩形表示,并标注实体名称
-
属性:用椭圆表示:并标注属性名称
-
关系:用菱形表示,并标注关系名称
-
一对一
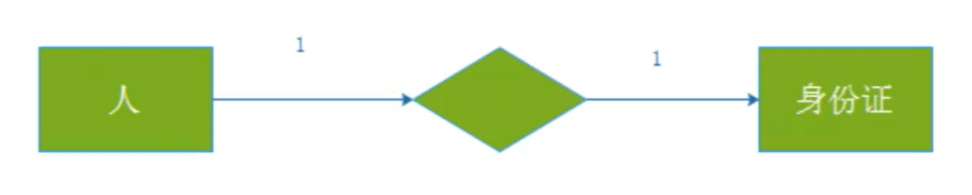
- 关系也是一种数据,需要通过一个字段储存在表中
- 1对1关系,在表A或表B中创建一个字段,存储另一个表的主键值
-
一对多
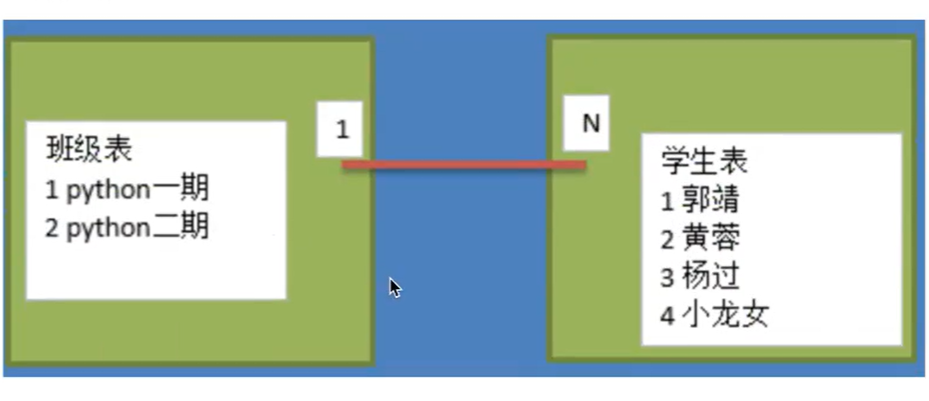
- 1对多关系,表中创建一个字段,储存班级表的主键值
-
多对多
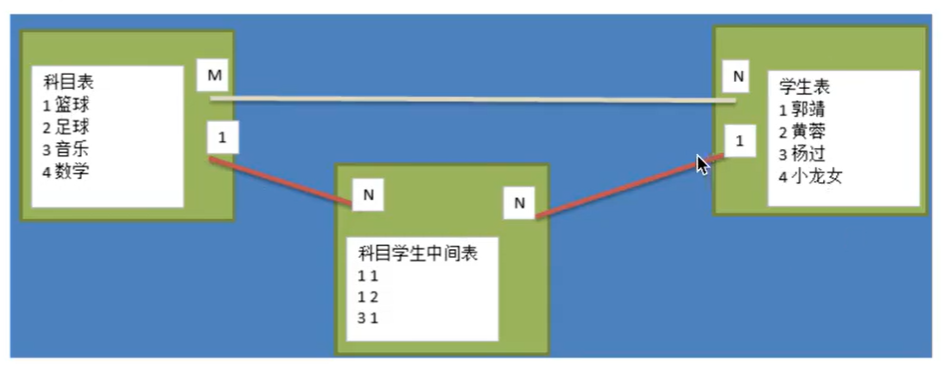
- 多对多关系,新建一张表C,这个表只有两个字段,一个用于存储A的主键值,一个用于存储B的主键值
-
9.外键约束SQL语句的编写
外键约束作用
外键约束:对外键字段的值进行更新和插入时会和引用表中字段的数据进行验证,数据如果不合法则更新和插入会失败,保证数据的有效性
对于已经存在的字段添加外键约束
为c_id字段添加外键约束
alter table students add foreign key(c_id) references classes(id);
在创建数据表时数设置外键约束
查看外键约束
show create table teacher;
结果:
| teacher | CREATE TABLE `teacher` (
  `id` int unsigned NOT NULL AUTO_INCREMENT,
  `name` varchar(10) NOT NULL,
  `s_id` int unsigned DEFAULT NULL,
  PRIMARY KEY (`id`),
  KEY `s_id` (`s_id`),
  CONSTRAINT `teacher_ibfk_1` FOREIGN KEY (`s_id`) REFERENCES `school` (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=4 DEFAULT CHARSET=utf8mb3 |
teacher_ibfk_1:外键约束的名称
创建学生表
create table school(id int unsigned not null primary key auto_increment, name varchar(30)) not null);
创建老师表
create table teacher(id int unsigned not null primary key auto_increment, name varchar(10) not null, s_id int unsigned, foreign key(s_id) references school(id));
删除外键约束
alter table teacher drop foreign key teacher_ibfk_1;
10.演练-分组和聚合函数的组合使用
数据准备:
-- 创建京东数据库
create database jing_dong charset=utf8;

-- 使用京东数据库
use jing_dong;

-- 创建一个商品 goodS 数据表
create table goods(id int unsigned primary key auto_increment not null, name varchar(150) not null, cate_name varchar(40) not null, brand_name varchar(40) not null, price decimal(10,3) not null default 0, is_show bit not null default 1, is_saleoff bit not null default 0);

-- 向goods表中插入数据
insert into goods values(0,'r7000p 15.6英寸游戏本','游戏本','联想','7999',1,1);
insert into goods values(0,'matebook 14英寸笔记本','笔记本','华为','5499',1,1);
insert into goods values(0,'xps13 13.3英寸超级本','超级本','戴尔','8999',1,1);
insert into goods values(0,'拯救者y9000x 16英寸游戏本','游戏本','联想','9999',1,1);
insert into goods values(0,'macbook air 13.6英寸笔记本','笔记本','苹果','7999',1,1);
insert into goods values(0,'pro16 16英寸笔记本','笔记本','华硕','6299',1,1);
insert into goods values(0,'zenbook 14 14英寸超级本','超级本','华硕','5799',1,1);
insert into goods values(0,'surface pro 12.3英寸平板','平板电脑','微软','6888',1,1);
insert into goods values(0,'g3 15.6英寸游戏本','游戏本','戴尔','6499',1,1);
insert into goods values(0,'magicbook 15.6英寸笔记本','笔记本','荣耀','4299',1,1);
insert into goods values(0,'rog幻16 16英寸游戏本','游戏本','华硕','12999',1,1);
insert into goods values(0,'thinkpad x1 14英寸超级本','超级本','联想','11999',1,1);
insert into goods values(0,'ipad pro 11英寸平板电脑','平板电脑','苹果','6799',1,1);
insert into goods values(0,'redmi book 14英寸笔记本','笔记本','小米','3899',1,1);
insert into goods values(0,'alienware m15 15.6英寸游戏本','游戏本','戴尔','15999',1,1);
insert into goods values(0,'matepad pro 11英寸平板','平板电脑','华为','3999',1,1);
insert into goods values(0,'vaio sx14 14英寸超级本','超级本','索尼','8499',1,1);
insert into goods values(0,'暗影精灵9 16.1英寸游戏本','游戏本','惠普','7299',1,1);
insert into goods values(0,'小新air14 14英寸笔记本','笔记本','联想','4599',1,1);
insert into goods values(0,'galaxy book2 15.6英寸笔记本','笔记本','三星','5199',1,1);
insert into goods values(0,'yoga pro14s 14.5英寸超级本','超级本','联想','8699',1,1);
insert into goods values(0,'ipad air 10.9英寸平板电脑','平板电脑','苹果','4799',1,1);
insert into goods values(0,'机械革命蛟龙16 16英寸游戏本','游戏本','机械革命','6999',1,1);
insert into goods values(0,'灵耀14 14英寸超级本','超级本','华硕','5999',1,1);
insert into goods values(0,'畅享平板2 10.1英寸平板','平板电脑','华为','1299',1,1);
insert into goods values(0,'游匣g15 15.6英寸游戏本','游戏本','戴尔','6799',1,1);
insert into goods values(0,'麦本本金麦6 13.3英寸笔记本','笔记本','麦本本','2999',1,1);
insert into goods values(0,'surface laptop go2 12.4英寸超级本','超级本','微软','4599',1,1);
insert into goods values(0,'真我平板x 11英寸平板电脑','平板电脑','真我','1899',1,1);
insert into goods values(0,'雷神911星战 15.6英寸游戏本','游戏本','雷神','6399',1,1);
表结构说明:
id:表示主键 自增name:表示商品名称cate_name:表示分类名称brand_name:表示品牌名称price:表示价格is_show:表示是否显示is_saleoff:表示是的售完
SQL语句演练
-
查询类型
cate_name为“超级本”的商品名称、价格select name,price from goods where cate_name='超级本'; -
显示商品的分类
select distinct cate_name from goods; select cate_name from goods group by cate_name; -
求所有电脑产品的平均价格,并保留两位数
select round(avg(price),2) from goods; -
显示每种商品的平均价格
select cate_name, avg(price) from goods group by cate_name; -- 保留两位小数 select cate_name, round(avg(price),2) from goods group by cate_name; -
查询每种类型的商品中,最贵、最便宜、平均价、数量
select cate_name, max(price), min(price), avg(price),count(*) from goods group by cate_name; -
查询所有价格大于平均价格的商品,并按价格降序排序
select * from goods where price>(select avg(price) from goods) order by price desc;
二十三、MySQL数据库的高级使用
1.将查询结果插入到其他表中
创建商品分类表
create table good_cates(id int unsigned not null primary key auto_increment, name varchar(50) not null);
查询goods表中商品的分类信息
select cate_name from goods group by cate_name;
将查询结果插入到good_cates表中
insert into good_cates(name) select cate_name from goods group by cate_name;
添加移动设备分类信息
insert into good_cates(name) values('移动设备');
2.使用连接更新表中的某个字段数据
查看goods表中商品分类名称对应的商品分类id
select g.cate_name, gs.id from goods as g inner join good_cates as gs on g.cate_name=gs.name;
将goods表中的分类名称更改成商品分类表中对应的分类id,连接更新表中的某个字段
update goods as g inner join good_cates as gs on g.cate_name=gs.name set g.cate_name =gs.id;
3.创建并给某个字段添加数据
创建品牌表
查询品牌信息
select brand_name from goods group by brand_name;
通过create table ... select来创建数据表并且同时插入数据
创建商品分类表,注:需要对brand_name用as取别名,否则name字段就没有值
create table good_brands(id int unsigned primary key auto_increment, name varchar(40) not null) select brand_name as name from goods group by brand_name;
说明:
create table ... select 列名 ..:表示创建表并插入数据
更新goods表中的品牌信息
将goods表中的品牌名称更改成品牌表中对应的品牌id
update goods as g inner join good_brands as gb on g.brand_name = gb.name set g.brand_name = gb.id;
4.修改goods表结构
修改goods表结构
目前我们已经把 goods 表中的商品分类和品牌信息已经更改成了商品分类 id 和品牌 id,接下来需要把 cate_name 和 brand name 字段分别改成 cate_id 和 brand id 字段,类型都改成int类型
查看表结构
desc goods;
通过alter table语句修改表结构
alter table goods change cate_name cate_id int not null, change brand_name brand_id int not null;
5.PyMySQL的使用
Python程序操作MySQL数据库
安装pymysql第三方包
pip install pymysql
说明:
- 安装命令使用:
pip install 第三方包名 - 卸载命令使用:
pip uninstall 第三方包
pymysql的使用
-
导入 pymysql 包
import pymysql -
创建连接对象
调用 pymysql 模块中的
connect()函数来创建连接对象,代码如下:conn = connect(参数列表)参数说明:
host:连接的MySQL主机,如本机是localhostport:连接的MySQL主机的端口,默认是 3306user:连接的用户名password:连接的密码detabase:数据库的名称charset:采用的编码方式,推荐使用utf8
连接对象操作说明:
- 关闭连接:
conn.close() - 提交数据:
conn.commit() - 撤销数据:
conn.rollback()
-
获取游标对象
获取游标对象的目标就是要执行SQL语句,完成对数据的增删改查操作
cursor = conn.cursor()游标操作说明:
- 使用游标执行SQL语句:
.execute()执行SQL语句,返回受影响的行数,主要用于执行insert、update、delete、select等语句 - 获取查询结果集中的一条数据:
.fetchone()返回一个元组,如:(1,'张三',...) - 获取查询结果集中的所有数据:
.fetchall()返回一个元组,如:((1,'张三',...),(2,'李四',...),...) - 关闭游标:
.close()表示和数据库操作完成
- 使用游标执行SQL语句:
-
pymysql完成数据的查询操作
# 导入包 import pymysql if __name__ == '__main__': # 创建连接对象 conn = pymysql.connect( host = '192.168.10.128', port = 3306, user = 'root', passwd = 'mysql', database = 'python1', charset = 'utf8' ) # 获取游标,目的是执行sql语句 cursor = conn.cursor() # 准备sql语句 sql = "select * from students;" # 执行sql语句 cursor.execute(sql) # 获取结果,返回的是一个元组类型 # 获取一条 row = cursor.fetchone() # 获取多条 # row = cursor.fetchall() print(row) # 关闭游标 cursor.close() # 关闭连接 conn.close() -
pymysql完成对数据的增删改
# 导入包 import pymysql if __name__ == '__main__': # 创建连接对象 conn = pymysql.connect( host = '192.168.10.128', port = 3306, user = 'root', passwd = 'mysql', database = 'python1', charset = 'utf8' ) # 获取游标,目的是执行sql语句 cursor = conn.cursor() # 准备sql语句 # 对数据表完成添加、删除、修改操作,需要把修改的数据提交到数据库 # 添加数据 # sql = "insert into classes(name) values('奥数');" # 修改数据 # sql = "update classes set name = '人工智能' where id = 5;" # 删除数据 sql = "delete from classes where id = 5;" try: # 执行sql语句 cursor.execute(sql) # 提交修改的数据到数据库 conn.commit() except Exception as e: # 对修改的数据进行撤销 conn.rollback() finally: # 关闭游标 cursor.close() # 关闭连接 conn.close() -
防止SQL注入
什么是SQL注入
用户提交带有恶意的数据与SQL语句进行字符串方式的拼接,从而影响了SQL语句的语义,最终产生数据泄露的现象
SQL语句参数化
- SQL语言中的参数使用
%s来占位,此处不是 Python 中的字符串格式化操作 - 将SQL语句中的
%s占位所需要的参数存在一个列表中,把参数列表传递给execute方法中的第二个参数
示例:
# 导入包 import pymysql if __name__ == '__main__': # 创建连接对象 conn = pymysql.connect( host = '192.168.10.128', port = 3306, user = 'root', passwd = 'mysql', database = 'python1', charset = 'utf8' ) # 获取游标,目的是执行sql语句 cursor = conn.cursor() # 准备sql语句,使用防止SQL注入的SQL语句,%s是SQL语句的参数,不要加引号 sql = "select * from students where name= %s;" # 执行sql语句 cursor.execute(sql,('熊大',)) # 获取结果,返回的是一个元组类型 # 获取一条 row = cursor.fetchone() # 获取多条 # row = cursor.fetchall() print(row) # 关闭游标 cursor.close() # 关闭连接 conn.close() - SQL语言中的参数使用
-
多个参数占位符写法
# 导入包
import pymysql

if __name__ == '__main__':
    # 创建连接对象
    conn = pymysql.connect(
        host = '192.168.10.128',
        port = 3306,
        user = 'root',
        passwd = 'mysql',
        database = 'python1',
        charset = 'utf8'
    )

    # 获取游标,目的是执行sql语句
    cursor = conn.cursor()

    # 准备sql语句
    sql = "insert into students(name,age,gender,c_id) values(%s,%s,%s,%s);"

    try:
        # 执行sql语句
        cursor.execute(sql,['王昭君', 20, '女',3])
        # 提交修改的数据到数据库
        conn.commit()
    except Exception as e:
        # 对修改的数据进行撤销
        conn.rollback()
    finally:
        # 关闭游标
        cursor.close()

        # 关闭连接
        conn.close()
6.事务
事务就是用户定义的一系列执行SQL语句的操作,这些操作要么完全地执行,要么完全地都不执行,它是一个不可分割的工作执行单元
事务的使用场景:
在日常生活中,有时我们需要进行银行转账了这个银行转账操作背后就是需要执行多个SQL语句,假如这些SQL执行到一半突然停电了,那么就会导致这个功能只完成了一半,这种情况是不允许出现,要想解决这个问题就需要通过事务来完成
事务的四大特性
-
原子性(Atomicity)
一个事务必须被视为一个不可分割的最小工作单元,整个事务中的所有操作要么全部提交成功,要么全部失败滚蛋,对于一个事务来说,不可能只执行其中的一部分操作,这就是事务的原子性
-
一致性(Consistency)
数据库总是从一个一致性的状态转换到另外一个一致性的状态,(在前面的例子中,一致性确保了,即使在转账过程中系统崩溃,支票账户中也不会损失200美元,因为事务最终没有提交,所以事务中所做的修改也不会保存到数据库中)
-
隔离性(Isolation)
通常来说,一个事务所做的修改操作在提交事务之前,对于其他事务来说是不可见的。(在前面的例子中,当执行完第三条语句、第四条语句还未开始时,此时有另外的一个账户汇总程序开始运行,则其看到支票帐户的余额并没有被减去200美元)
-
持久性(Durability)
一旦事务提交,则所做的修改会永久保存到数据库
说明:
事务能够保证数据的完整性和一致性,让用户的操作更加安全
事务的使用
在使用事务之前,先要确保表存储的引擎是 InnoDB 类型,只有这个类型才可以使用事务,MySQL数据库中表的存储引擎默认是 InnoDB 类型
表的存储引擎就是提供存储数据一种机制,不同表的存储引擎提供不同的储存机制
查看MySQL数据库支持的表的存储引擎
show engines;
说明:
- 常用的表的存储引擎是 InnoDB 和 MyISAM
- InnoDB 是支持事务的
- MyISAM 不支持事务,优势是访问速度快,对事务没有要求或者以
select、insert为主的都可以使用该存储引擎来创建表
查看 goods 表的创表语句:
-- 选择数据库
use jing_dong;
-- 查看 goods 表的创表语句
show create table goods;
结果:
| goods | CREATE TABLE `goods` (
  `id` int unsigned NOT NULL AUTO_INCREMENT,
  `name` varchar(150) NOT NULL,
  `cate_id` int NOT NULL,
  `brand_id` int NOT NULL,
  `price` decimal(10,3) NOT NULL DEFAULT '0.000',
  `is_show` bit(1) NOT NULL DEFAULT b'1',
  `is_saleoff` bit(1) NOT NULL DEFAULT b'0',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=31 DEFAULT CHARSET=utf8mb3 |
说明:
- 通过创表语句可以得知,goods表的存储引擎是 InnoDB
- 修改表的存储引擎使用:
alter table 表名 engine = 引擎类型- 比如:
alter table students engine = 'MyISAM';
- 比如:
开启事务
begin;
-- 或者
start transaction;
说明:
- 开启事务后执行修改命令,变更数据会保存到MySQL服务端的缓存文件中,而不维护到物理表中
- MySQL数据库默认采用自动提交(autocommit)模式,如果没有显示的开启一个事务,那么每条SQL语句都会被当做一个事务执行提交操作
- 当设置 autocommit=0 就是取消了自动提交事务模式,知道显示的执行 autocommit 和 rollback 表示该事物结束
- autocommit=0 表示取消自动提交事务模式,需要手动执行 autocommit 完成事务的提交
set autocommit = 0;
insert into classes(name) values('奥数');
-- 需要手动提交
commit;

-- 重新打开一个终端窗口,连接MySQL数据库服务端
mysql -uroot -p
-- 查询数据,如果上个窗口执行了 commit,这个窗口才能看到数据
select * from students;
提交事务
将本地缓存文件中的数据提交到物理表中,完成数据的更新
commit;
回滚事务
放弃本地缓存文件中的缓存数据,表示回到开始事务的状态
rollback;
总结:
-
事务的特性:
- 原子性: 强调事务中的多个操作时一个整体
- 一致性: 强调数据库中不会保存不一致状态
- 隔离性: 强调数据库中事务之间相互不可见。持久性:强调数据库能永久保存数据,一旦提交就不可撤销
-
MSQL数据库默认采用自动提交(autocommit)模式,也就是说修改数据(
insert、update、delete)的操作会自动的触发事务,完成事务的提交或者回滚 -
开启事务使用
begin;或者start transaction; -
回滚事务使用
rollback; -
pymysql里面的
conn.commit()操作就是提交事务 -
pymysql 里面的
conn.rollback()操作就是回滚事务
7.索引
索引的介绍
索引在MySQL中也叫做“键”,它是一个特殊的文件,它保存着数据表里的所有记录的位置信息,更通俗的来说,数据库索引好比是一本书前面的目录,能加快数据库的查询速度
应用场景
当数据库中的数据量很大时,查找数据会变得很慢,我们就可以通过索引来提高数据库的查询效率
索引的使用
查询表中已有的索引
show index from 表名;
说明:
- 主键列会自动创建索引
- 外键约束这个字段也会自动创建索引
索引的创建
创建索引的语法格式
alter table 表名 add index 索引名[可选](列名,...);
给name字段添加索引
alter table classes add index my_name(name);
-- 索引名可以不写
alter table classes add index(name);
说明:
- 索引名不指定,默认使用字段名
索引的删除
删除索引的语法格式
alter table 表名 drop index 索引名;
如果不知道索引名,可以查看创表sql语句
show create table classes;
-
结果
| classes | CREATE TABLE `classes` (
  `id` int unsigned NOT NULL AUTO_INCREMENT,
  `name` varchar(20) NOT NULL,
  PRIMARY KEY (`id`),
  KEY `my_name` (`name`)
) ENGINE=InnoDB AUTO_INCREMENT=8 DEFAULT CHARSET=utf8mb3 |
其中
KEY `my_name` (`name`)中的my_name就是name字段的索引名
删除索引
alter table classes drop index my_name;
案例-验证索引查询性能
创建测试表test_index:
create table test_index(name varchar(10));
向表中插入一万条数据:
import pymysql
def main ():
    # 创建连接对象
    conn = pymysql.connect(
        host = '192.168.10.128',
        port = 3306,
        user = 'root',
        passwd = 'mysql',
        database = 'python1',
        charset = 'utf8'
    )
    # 获取游标
    cursor = conn.cursor()
    sql = "insert into test_index(name) values(%s);"
    # 循环执行一万次插入数据的操作
    try:
        for i in range(10000):
            # 执行SQL
            cursor.execute(sql, ['test'+str(i),])
        # 提交数据到数据库
        conn.commit()
    except Exception as e:
        # 回滚数据
        conn.rollback()
    finally:
        # 关闭游标
        cursor.close()
        # 关闭连接
        conn.close()

if __name__ == '__main__':
    main()
验证索引性能操作
开启运行时间监测
set profiling = 1;
查找第一万条数据test9999
select * from test_index where name='test9999';
查看执行时间
show profiles;
给name字段创建索引
alter table test_index add index(name);
再执行一次查询语句
select * from test_index where name='test9999';
再查看一次执行的时间
show profiles;
结果:
+----------+------------+------------------------------------------------+
| Query_ID | Duration   | Query                                          |
+----------+------------+------------------------------------------------+
|        1 | 0.00852925 | select * from test_index where name='test9999' |
|        2 | 0.11075650 | alter table test_index add index(name)         |
|        3 | 0.00053750 | select * from test_index where name='test9999' |
+----------+------------+------------------------------------------------+
没加索引查询时间为0.00852925,加了索引的查询时间为0.00053750
联合索引
联合索引也叫复合索引,即一个索引覆盖表中的两个或者多个字段,一般用在多个字段一起查询的时候
创建teacher表
create table my_test(id int unsigned not null primary key auto_increment, name varchar(10), age int not null);
创建联合索引
alter table my_test add index (name,age);
联合索引的好处
- 减少磁盘空间的开销,因为每创建一个索引,其实就是创建了一个索引文件,那么会增加磁盘空间的开销
结果:
| my_test | CREATE TABLE `my_test` (
  `id` int unsigned NOT NULL AUTO_INCREMENT,
  `name` varchar(10) DEFAULT NULL,
  `age` int NOT NULL,
  PRIMARY KEY (`id`),
  KEY `name` (`name`,`age`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb3 |
KEY `name` (`name`,`age`):就是联合索引的结果
联合索引的最左原则
在使用联合索引的时候,我们要遵循一个最左原则,即index(name, age)支持name、age组合查询,而不支持单独的age查询,应为没有用到创建的联合索引
最左原则示例:
-- 下面查询使用了联合索引
select * from students where name = '张三';
select * from students where name = '小乔' and age = 24;
-- 下面查询没有使用联合索引
select * from students where age = 24;
说明:
- 在使用联合索引查询数据的时候,一定要保证联合索引的最左侧字段出现在查询条件里面,否则联合索引失效
MySQL中索引的优缺点和使用原则
- 优点:
- 加快数据的查询速度
- 缺点:
- 创建索引会耗费时间和占用磁盘空间,并且随着数据量的增加所耗费的时间也会增加
- 使用原则:
- 通过优缺点对比,不是索引越多越好,而是需要自己和合理使用
- 对经常更新的表就避免对其进行过多索引的创建,对经常用于查询的字段应该创建索引
- 数据量小的表,最好不要使用索引,因为由于数据较少,可能查询全部数据花费的时间比遍历索引的时间还要短,索引就可能不会产生优化效果
- 在一字段上相同值比较多不要建立索引,比如在学生表的“性别”字段上只有男,女两个不同的值,相反的,在一个字段上不同值较多可建立索引
二十四、闭包和装饰器
1.闭包
闭包的定义
在函数嵌套的前提下,内部函数使用了外部函数的变量,并且外部函数返回了内部函数,我们把这个使用外部函数变量的内部函数称为闭包
闭包的构成条件
通过闭包的定义,我们看得知闭包的形成条件
- 在函数嵌套(函数里面再定义函数)的前提下
- 内部函数使用了外部函数的变量(还包括外部函数的参数)
- 外部函数返回了内部函数
简单的闭包示例
def func_out():
    # 外部函数
    num1 = 10
    def func_inner(num2):
        # 内部函数
        # 内部函数使用外部函数变量
        add = num1 + num2
        print(f'结果是:{add}')
    # 外部函数返回内部函数
    return func_inner


if __name__ == '__main__':
    new_func = func_out()
    new_func(22)
    new_func(2)
运行结果:
结果是:32
结果是:12
闭包执行结果说明:
通过上面的输出结果可以看出,闭包保存了外部函数内的变量num1,每次执行闭包都是在num = 1基础上进行计算
闭包的作用
- 闭包可以保存外部函数内的变量,不会随着外部函数调用完而销毁
注意点:
- 由于闭包引用了外部函数的变量,则外部函数的变量没有及时释放,消耗内存
2.闭包的使用
案例
需求:根据配置信息使用闭包实现不同人的对话信息,例如对话:
张三:到北京了吗?
李四:已经到了,放心吧
实现步骤说明
- 定义外部函数接收不同的配置信息参数,参数是人名
- 定义内部函数接收对话信息参数
- 在内部函数里面把配置形象和对话信息进行拼接输出
功能代码的实现
# 外部函数接收姓名参数
def config_name(name):
    # 内部函数保存外部函数的参数,并且完成数据显示的储存
    def inner(say):
        print(name + ":" + say)
    # 外部函数返回内部函数
    return inner

if __name__ == '__main__':
    # 创建TOM闭包实例
    tom = config_name('tom')
    # 创建jerry闭包实例
    jerry = config_name('jerry')
    # 执行闭包
    tom("你到北京了吗?")
    jerry("已经到了,你放心吧。")
3.修改闭包内使用的外部变量
修改闭包内使用的外部变量
修改闭包内使用的外部变量的示例:
def func_out():
    num1 = 10
    def func_inner():
        # 在闭包内修改外部函数的变量,其实是定义了一个局部变量
        # num1 = 20
        # 在闭包内修改外部函数的变量需要使用nonlocal关键字
        nonlocal num1
        num1 = 20
        sum_num = num1 + 10
        print(sum_num)

    print("修改前的外部变量", num1)
    func_inner()
    print("修改后的外部变量", num1)
    return func_inner

new_func = func_out()
new_func()
4.装饰器
装饰器的定义
就是给已有的函数增加额外功能的函数,它本质上就是一个闭包函数
装饰器的功能特点
- 不修改已有函数的源代码
- 不修改已有函数的调用方式
- 给已有函数增加额外的功能
装饰器的示例
# 定义装饰器
def decorator(func):    # 如果闭包函数的参数有且只有一个,并且是函数类型,那么这个闭包函数称为装饰器
    def inner():
        # 在内部函数里面对已有函数进行装饰
        print('已添加登录验证')
        func()
    return inner

def comment():
    print('发表评论')

if __name__ == '__main__':
    # 调用装饰器,对已有函数进行装饰
    comment = decorator(comment)
    # 调用方式不变
    comment()
装饰器语法糖写法
如果多个函数都需要添加登录验证功能,每次都需要写comment = decorator(comment)这样代码对已有函数进行装饰,做法阿是比较麻烦
python给提供了一个装饰函数更加简单的写法—语法糖,语法糖的书写格式是@装饰器名通过语法糖的方式也可以完成对已有函数的装饰
# 定义装饰器
def decorator(func):    # 如果闭包函数的参数有且只有一个,并且是函数类型,那么这个闭包函数称为装饰器
    def inner():
        # 在内部函数里面对已有函数进行装饰
        print('已添加登录验证')
        func()
    return inner
@decorator      # 装饰器的语法糖写法
def comment():
    print('发表评论')

if __name__ == '__main__':
    # # 调用装饰器,对已有函数进行装饰
    # comment = decorator(comment)
    # 调用方式不变
    comment()
装饰器的执行时机:当当前模块加载完成以后,装饰器会立即执行对已有函数进行装饰
5.装饰器的使用
装饰器的使用场景
- 函数执行时间的统计
- 输出日志信息
装饰器实现已有函数执行时间的统计
import time

def get_time(fn):
    def inner():
        # 获取当前时间,距离1970年1月1日0时0分1秒的时间差
        begin = time.time()
        fn()
        end = time.time()
        result = end - begin
        print('执行完成,共耗时:', result)
    return inner

@get_time   # work = get_time(work), work = inner
def work():
    for i in range(10000):
        print(i)

if __name__ == '__main__':
    work()
6.通用装饰器的使用
可以装饰任意类型的函数
装饰带有参数的函数
# 装饰带有参数的函数
def func_out(fn):
    def inner(num1, num2):
        print('正在努力进行计算...')
        fn(num1, num2)

    return inner


@func_out
def add_num(num1, num2):
    result =  num1 + num2
    print(f'结果是:{result}')


if __name__ == '__main__':
    add_num(1,2)
注:使用装饰器装饰已有函数的时候,内部函数的类型和已有函数的必须类型保持一致
装饰带参数和返回值的函数
# 装饰带参数和返回值的函数
def func_out(fn):
    def inner(num1, num2):
        print('正在努力进行计算...')
        num = fn(num1, num2)
        return num

    return inner


@func_out
def add_num(num1, num2):
    result =  num1 + num2
    return result


if __name__ == '__main__':
    result_sum = add_num(1,2)
    print(result_sum)
装饰带有不定长参数和返回值的函数
该装饰器还可以称为是通用的装饰器
# 装饰带有不定长参数和返回值的函数
def func_out(fn):
    def inner(*args, **kwargs):
        print('正在努力进行计算...')
        num = fn(*args, **kwargs)
        return num

    return inner


@func_out
def add_num(*args, **kwargs):
    result = 0
    # args:元组类型
    # kwargs:字典类型
    for value in args:
        result += value
    for value in kwargs.values():
        result += value
    return result


if __name__ == '__main__':
    result_sum = add_num(1,2)
    print(f'结果为:{result_sum}')
*args:把元组里面的每一个元素,按照位置参数的方式进行传参
**kwargs:把字典里面的每一个键值对,按照关键字的方式进行传参
这里对元组和字典进行拆包,仅限于结合不定长参数的函数使用
7.多个装饰器的使用
# 定义装饰器
def make_div(fn):
    print('make_div')
    def inner():
        # 在内部函数对已有函数进行装饰
        result = '<div>'+ fn() + '</div>'
        return result
    return inner


def make_p(fn):
    print('make_p')
    def inner():
        # 在内部函数对已有函数进行装饰
        result = '<p>'+ fn() + '</p>'
        return result
    return inner

@make_div
@make_p
def content():
    return '666'

if __name__ == '__main__':
    new_result = content()
    print(new_result)
    # 需要达到如下效果:<p>666</p>
多个装饰器的过程:由内到外的一个装饰过程,先执行内部的装饰器,再执行外部的装饰器
原理剖析:content = make_div(make_p(content))
分布拆解
content = make_p(content)内部装饰器装饰完成content = make_p.innercontent = make_div(make_p.inner)
8.带有参数的装饰器
带有参数的装饰器介绍
带有参数的装饰器就是使用装饰器装饰函数的时候可以传入指定参数,语法格式:@装饰器名(参数,...)
def return_func_out(flag):
    # 定义装饰器
    def func_out(fn):
        def inner(a, b):
            if flag == '+':
                print('正在执行加法计算loading...')
            elif flag == "-":
                print('正在执行减法法计算loading...')
            fn(a, b)
        return inner
    # 当调用该函数的时候,可以返回一个装饰器
    return func_out

# 加法计算
"""
func_out = return_func_out('+')
@return_func_out('+') ==> add_num = func_out(add_num)
"""
@return_func_out('+')
def add_num(a, b):
    print(a + b)

# 减法计算
@return_func_out('-')
def sub_num(a, b):
    print(a - b)

if __name__ == '__main__':
    add_num(1, 2)
    sub_num(1, 2)
带有参数的装饰器,其实就是定义了一个函数,让函数接收参数,在函数内部返回的是一个装饰器
9.类装饰器的使用
类装饰器的介绍
装饰器还有一种特殊的用法就是类装饰器,就是通过定义一个类来装饰函数
类装饰器示例:
class Char(object):
    def __init__(self, fn):
        self.__fn = fn
    # 实现__call__这个方法,让对象变成可调用的对象,可调用的对象能够像函数一样使用
    def __call__(self, *args, **kwargs):
        # 对已有函数进行封装
        print('现在下午5:55分')
        self.__fn(*args, **kwargs)

@Char
def show():
    print('快要下班了')

if __name__ == '__main__':
    # 执行show() ==> 执行Char类创建的实例对象
    show()
扩展
-
函数之所以能够调用是因为函数内部使用了
__call__方法def mytest(): print(6) print(dir(mytest))dir()函数:用于返回对象的所有属性和方法的列表
二十五、mini-Web框架
1.web框架概述
web框架和web服务器的关系介绍
使用web框架专门负责处理用户的动态资源请求,这个web框架其实就是一个为web服务器提供服务的应用程序,简称web框架
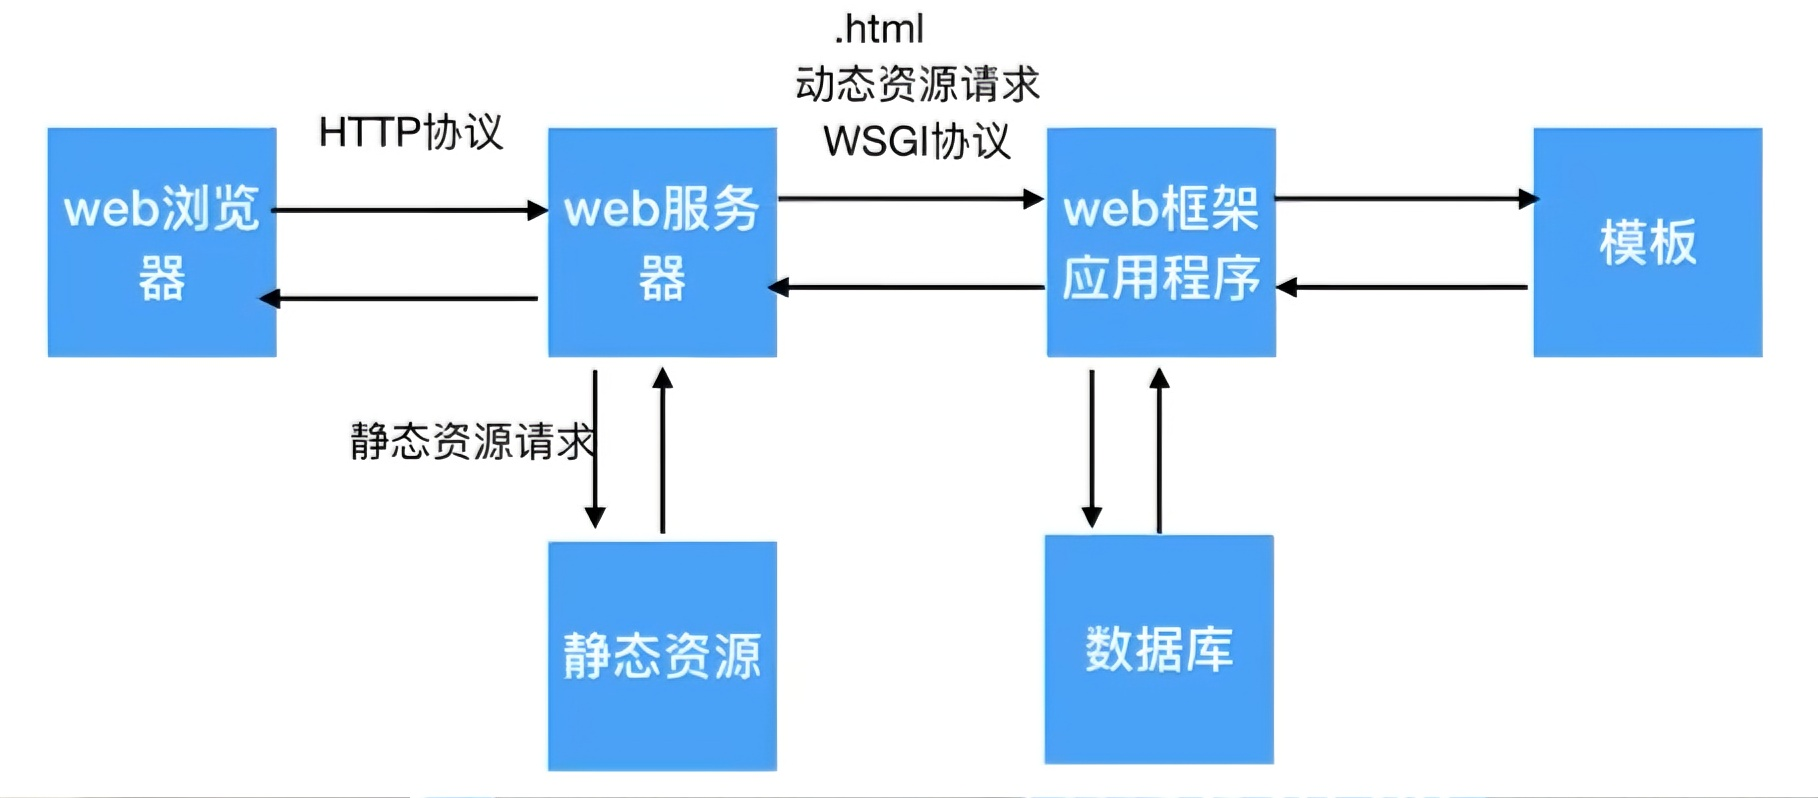
关系说明:
- web服务器接收浏览器发起的请求,如果是动态资源请求找web框架来处理
- web框架复制处理浏览器的动态资源请求,把处理的结果发送给web服务器
- web服务器再把响应结果发送给浏览器
静态资源
不需要经常变化的资源,这种资源web服务器可以提前准备好,比如:.png、.jpg、.css、.js等文件
动态资源
和静态资源相反,这种资源会经常变化,比如:我们在京东浏览商品时经常会更具条件进行筛选,选择不同条件,浏览不同的商品,这种资源web服务器无法提前准备好,需要web框架来帮web服务器进行准备,这里web服务器可以把.html的资源请求认为是动态资源请求交由web框架进行处理
WSGI协议
它是web服务器和web框架之间进行协调工作的一个规则,WSGI协议规定web服务器把动态资源请求的信息传给web框架处理,web框架把处理好的结果返回给web服务器
总结
- web框架是专门为web服务器处理动态资源请求的一个应用程序
- web框架和web服务器的关系是web框架专门服务于web服务器,给web服务器提供处理动态资源请求的服务
2.框架程序开发
框架职责介绍
- 接收web服务器的动态资源请求,给web服务器提供处理动态资源请求的服务
动态资源判断
- 根据请求资源路径的后缀名进行判断
- 如果请求资源路径的后缀名是
.html则是动态资源请求,让web框架程序进行处理 - 否则是静态资源请求,让web服务器程序进行处理
- 如果请求资源路径的后缀名是
web服务器程序(web.py)代码:
import socket
import threading
import sys
import framework

# HTTP协议的Web服务器类
class HttpWebServer(object):
    def __init__(self, port):
        server_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
        # 绑定端口
        server_socket.bind(('', port))
        # 设置端口复用
        server_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, True)
        # 设置监听(最大128位)
        server_socket.listen(128)
        # 把TCP服务器套接字作为web服务器对象属性
        self.server_socket = server_socket

    # 处理客户端请求
    @staticmethod
    # @staticmethod 是 Python 类中的静态方法装饰器,作用是定义一个与类和实例都无关的方法—— 它既不需要访问类属性,也不需要访问实例属性。
    def process(new, port):
        print(f'已与{port}建立连接')

        # 接收TCP客户端程序数据(最大4096字节)
        user_data = new.recv(4096)

        # 判断是否为空数据
        if len(user_data) == 0:
            print(f'{port}已下线...')
            new.close()
            return

        # 对客户端发送的数据进行转换
        user_data_info = user_data.decode("utf-8")
        # 对数据按照空格进行分割
        user_list = user_data_info.split(' ', maxsplit=2)
        # 获取请求路径
        user_name = user_list[1]

        if user_name == '/':
            # 指定路径
            user_name = '/index.html'

        # 判断是否是动态资源请求,以后把后缀.html的请求认为是动态资源请求
        if user_name.endswith(".html"):
            """动态资源请求"""
            # 动态资源请求找web框架进行处理,需要把请求参数给web框架
            # 准备给web框架的参数信息,都要放在字典内
            env = {
                "user_name": user_name,
                # 传入请求头信息,额外的参数可以在字典里面再添加
            }
            # 1.使用框架处理动态资源请求,web框架需要把处理结果返回给web服务器
            # 2.web服务器负责把返回的结果封装成响应报文发送给浏览器
            # 状态信息,响应头信息,响应体信息
            status, headers, response_body = framework.hande_request(env)
            print(status, headers,response_body)
            # 响应行
            response_line = "HTTP/1.1 %srn" % status
            # 响应头
            response_header = ""
            for header in headers:
                response_header += "%s: %srn" % header
            # 响应报文
            response_date = (response_line +
                             response_header +
                             "rn" +
                             response_body).encode("utf-8")
            # 发送响应报文数据给浏览器
            new.send(response_date)
            # 关闭连接
            new.close()


        else:
            """静态资源请求"""
            # 查看有无这个文件
            try:
                # 打开文件
                # 为了兼容图片使用rb打开
                with open(f"HTTP静态{user_name}", "rb") as file:  # file表示打开文件的对象
                    # with open 读取数据后关闭文件不需要程序员来完成,系统自己关闭
                    file_data = file.read()

            except Exception as e:
                # 到这里说明请求的没有该文件,返回404
                # 响应行
                not_line = 'HTTP/1.1 404 Not Foundrn'
                # 响应头
                not_head = 'Server: PWS/1.0rn'
                with open("HTTP静态/404.html", "rb") as file:
                    not_file = file.read()

                not_info = (not_line + not_head + "rn").encode("utf-8") + not_file
                new.send(not_info)
            else:
                # 把数据封装成HTTP响应报文格式
                # 响应行
                line = 'HTTP/1.1 200 OKrn'
                # 响应头
                head = 'Server: PWS/1.0rn'
                # 响应体
                http_body = file_data
                # 合并
                rdr_info = (line + head + "rn").encode("utf-8") + http_body
                # 发送响应报文数据
                new.send(rdr_info)
            finally:
                # 断开连接
                new.close()
                print(f'{port}已下线...')

    # 启动服务器方法
    def start(self):
        while True:
            new, port = self.server_socket.accept()
            sub_process = threading.Thread(target=self.process, args=(new, port), daemon=True)
            sub_process.start()

def main():
    # 获取终端命令行参数
    parms = sys.argv

    if len(parms) != 2:
        print('格式错误!如下:')
        print('python xxx.py 端口号(数字)')
        return

    # 判断第二个参数是否都是由数字组成
    if not parms[1].isdigit():
        print('格式错误!如下:')
        print('python xxx.py 端口号(数字)')
        return

    port = int(parms[1])
    print(f'成功!你的端口号是{port}')
    # 创建web服务器
    http = HttpWebServer(port)
    # 启动!!!
    http.start()

if __name__ == '__main__':
    main()
web框架程序(framework.py)代码:
import time
"""web框架的职责,专门负责处理动态资源请求"""
# 获取首页数据
def index():
    # 状态信息
    status = "200 OK"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # web框架处理后的数据
    date = time.ctime()     # 获取当前时间
    # 这里返回的是元组
    return status, response_header, date

# 处理没有找到的动态资源
def not_found():
    # 状态信息
    status = "404 Not Found"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # web框架处理后的数据
    date = "Not Found"
    # 这里返回的是元组
    return status, response_header, date

# 处理动态资源请求
def hande_request(evn):
    # 获取动态的请求资源路径
    request_path = evn["user_name"]
    print(f"动态资源请求的地址:{request_path}")
    # 判断请求的资源路径,选择指定的函数处理对应的动态资源请求
    if request_path == "/index.html":  # 如果是首页
        # 获取首页数据
        result = index()
        return result
    else:
        # 没有这个页面,返回404页面
        result = not_found()
        return result
3.模板替换功能开发
framework.py代码
import time
"""web框架的职责,专门负责处理动态资源请求"""
# 获取首页数据
def index():
    # 状态信息
    status = "200 OK"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # 打开指定的模板文件,读取模板文件中的数据
    with open("HTTP动态/index.html", "r",encoding='utf-8') as f:
        f_data = f.read()
    # 查询数据库,将数据库中的数据,把模板里的模板变量({% content %}),替换成数据库中的数据
    # 获取当前时间,模拟数据库内容
    date = time.ctime()     # 获取当前时间
    response_body = f_data.replace("{% content %}", date)
    # 这里返回的是元组
    return status, response_header, response_body

# 处理没有找到的动态资源
def not_found():
    # 状态信息
    status = "404 Not Found"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # web框架处理后的数据
    date = "Not Found"
    # 这里返回的是元组
    return status, response_header, date

# 处理动态资源请求
def hande_request(evn):
    # 获取动态的请求资源路径
    request_path = evn["user_name"]
    print(f"动态资源请求的地址:{request_path}")
    # 判断请求的资源路径,选择指定的函数处理对应的动态资源请求
    if request_path == "/index.html":  # 如果是首页
        # 获取首页数据
        result = index()
        return result
    else:
        # 没有这个页面,返回404页面
        result = not_found()
        return result
index.html代码
<!DOCTYPE html>
<html lang="zh-CN">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>股票实时信息</title>
    <style>
        body { font-family: "微软雅黑", sans-serif; margin: 20px; }
        .stock-card { border: 1px solid #eee; border-radius: 8px; padding: 20px; max-width: 600px; margin: 0 auto; }
        .stock-title { color: #333; border-bottom: 2px solid #4285f4; padding-bottom: 10px; }
        .stock-table { width: 100%; border-collapse: collapse; margin-top: 15px; }
        .stock-table td { padding: 10px; border-bottom: 1px solid #f0f0f0; }
        .stock-table td:first-child { color: #666; width: 35%; }
        .rise { color: #ff4444; }
        .fall { color: #00cc66; }
    </style>
</head>
<body>
    <div class="stock-card">
        <h2 class="stock-title">股票实时行情</h2>
        <!-- 仅保留一个统一占位符 -->
        {% content %}
    </div>
</body>
</html>
4.路由列表功能开发
center.html代码
<!DOCTYPE html>
<html lang="zh-CN">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>个人中心</title>
    <style>
        * {
            margin: 0;
            padding: 0;
            box-sizing: border-box;
            font-family: Arial, sans-serif;
        }
        body {
            padding: 20px;
            background: #f8f8f8;
        }
        h1 {
            text-align: center;
            color: #333;
            margin-bottom: 30px;
        }
        .user-info {
            text-align: center;
            margin-bottom: 30px;
        }
        .user-info p {
            font-size: 16px;
            color: #666;
            margin-top: 10px;
        }
        .func-list {
            background: white;
            border-radius: 5px;
            padding: 10px;
        }
        .func-item {
            padding: 15px;
            border-bottom: 1px solid #eee;
        }
        .func-item:last-child {
            border: none;
        }
        .func-item a {
            text-decoration: none;
            color: #333;
            font-size: 16px;
        }
        .logout {
            display: block;
            width: 100%;
            padding: 12px;
            margin-top: 20px;
            border: none;
            background: #e64340;
            color: white;
            font-size: 16px;
            border-radius: 5px;
            cursor: pointer;
        }
        /* 动态内容区域样式 */
        .dynamic-content {
            margin: 20px 0;
            padding: 15px;
            background: white;
            border-radius: 5px;
            color: #333;
        }
    </style>
</head>
<body>
    <h1>个人中心</h1>

    <!-- 用户信息 -->
    <div class="user-info">
        <h3>用户名:张三</h3>
        <p>会员等级:普通会员</p>
    </div>

    <!-- 动态内容占位符(核心新增) -->
    <div class="dynamic-content">
        {% content %}
    </div>

    <!-- 功能入口 -->
    <div class="func-list">
        <div class="func-item"><a href="#">我的订单</a></div>
        <div class="func-item"><a href="#">收货地址</a></div>
        <div class="func-item"><a href="#">账户设置</a></div>
        <div class="func-item"><a href="#">帮助中心</a></div>
    </div>

    <!-- 退出按钮 -->
    <button class="logout">退出登录</button>
</body>
</html>
路由的介绍
路由就是请求的URL到处理函数时的映射,也就是说,提前把请求的URL和处理函数关联好
路由列表
路由的管理可以通过使用一个路由列表进行管理,通过路由列表保存每一个路由
| 请求路径 | 处理函数 |
|---|---|
| /login.html | login函数 |
| /index.html | index函数 |
| /center.html | center函数 |
示例:
import time
"""web框架的职责,专门负责处理动态资源请求"""
# 获取首页数据
def index():
    # 状态信息
    status = "200 OK"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # 打开指定的模板文件,读取模板文件中的数据
    with open("HTTP动态/index.html", "r",encoding='utf-8') as f:
        f_data = f.read()
    # 查询数据库,将数据库中的数据,把模板里的模板变量({% content %}),替换成数据库中的数据
    # 获取当前时间,模拟数据库内容
    date = time.ctime()     # 获取当前时间
    response_body = f_data.replace("{% content %}", date)
    # 这里返回的是元组
    return status, response_header, response_body

# 处理没有找到的动态资源
def not_found():
    # 状态信息
    status = "404 Not Found"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # web框架处理后的数据
    date = "Not Found"
    # 这里返回的是元组
    return status, response_header, date

def center():
    # 状态信息
    status = "200 OK"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # 打开指定的模板文件,读取模板文件中的数据
    with open("HTTP动态/center.html", "r", encoding='utf-8') as f:
        f_data = f.read()
    # 查询数据库,将数据库中的数据,把模板里的模板变量({% content %}),替换成数据库中的数据
    # 获取当前时间,模拟数据库内容
    date = time.ctime()  # 获取当前时间
    response_body = f_data.replace("{% content %}", date)
    # 这里返回的是元组
    return status, response_header, response_body

# 路由列表,列表里面的每一条记录都是一个路由
route_list = [
    ("/index.html", index),
    ("/center.html", center),
    ("/not_found.html", not_found),
]

# 处理动态资源请求
def hande_request(evn):
    # 获取动态的请求资源路径
    request_path = evn["user_name"]
    # 遍历路由列表,匹配请求的url
    for path, func in route_list:
        if request_path == path:
            # 找到了指定路由,执行对应的处理函数
            result = func()
            return result
    else:
        # 没有这个页面,返回404页面
        result = not_found()
        return result
5.装饰器方式添加路由
可以自动添加路由
import time
"""web框架的职责,专门负责处理动态资源请求"""

# 路由列表,列表里面的每一条记录都是一个路由
route_list = [
    # ("/index.html", index),
    # ("/center.html", center),
    # ("/not_found.html", not_found),
]

# 定义一个带有参数的装饰器
def func_data(fand):
    # 装饰器
    def out(fn):
        # 当执行装饰器的时候,就需要把路由添加到路由列表里面
        # 当装饰函数的时候,只添加一次路由即可
        route_list.append((fand, fn))
        def inner():
            result = fn()
            return result
        return inner
    return out

# 获取首页数据
@func_data("/index.html")
def index():
    # 状态信息
    status = "200 OK"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # 打开指定的模板文件,读取模板文件中的数据
    with open("HTTP动态/index.html", "r",encoding='utf-8') as f:
        f_data = f.read()
    # 查询数据库,将数据库中的数据,把模板里的模板变量({% content %}),替换成数据库中的数据
    # 获取当前时间,模拟数据库内容
    date = time.ctime()     # 获取当前时间
    response_body = f_data.replace("{% content %}", date)
    # 这里返回的是元组
    return status, response_header, response_body

# 处理没有找到的动态资源
@func_data("/not_found.html")
def not_found():
    # 状态信息
    status = "404 Not Found"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # web框架处理后的数据
    date = "Not Found"
    # 这里返回的是元组
    return status, response_header, date

@func_data("/center.html")
def center():
    # 状态信息
    status = "200 OK"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # 打开指定的模板文件,读取模板文件中的数据
    with open("HTTP动态/center.html", "r", encoding='utf-8') as f:
        f_data = f.read()
    # 查询数据库,将数据库中的数据,把模板里的模板变量({% content %}),替换成数据库中的数据
    # 获取当前时间,模拟数据库内容
    date = time.ctime()  # 获取当前时间
    response_body = f_data.replace("{% content %}", date)
    # 这里返回的是元组
    return status, response_header, response_body

# 处理动态资源请求
def hande_request(evn):
    # 获取动态的请求资源路径
    request_path = evn["user_name"]
    # 遍历路由列表,匹配请求的url
    for path, func in route_list:
        if request_path == path:
            # 找到了指定路由,执行对应的处理函数
            result = func()
            return result
    else:
        # 没有这个页面,返回404页面
        result = not_found()
        return result

if __name__ == '__main__':
    # 测试装饰器是否成功添加路由
    print(route_list)
6.显示股票信息页面的开发
数据准备
-- 创建数据库
create database stock_db charset=utf8;
-- 切换数据库
use stock_db;
-- 执行sql文件
source stock_db.sql;
stock_db.sql文件的代码
CREATE TABLE stock_info (
  id INT COMMENT '序号',
  code CHAR(6) COMMENT '股票代码',
  name VARCHAR(20) COMMENT '股票名称',
  rise_rate DECIMAL(5,2) COMMENT '涨幅(%)',
  rise_rate2 DECIMAL(5,2) COMMENT '第二涨幅(%)',
  price1 DECIMAL(8,2) COMMENT '价格1',
  price2 DECIMAL(8,2) COMMENT '价格2',
  date DATE COMMENT '日期'
) COMMENT '股票信息表';

INSERT INTO stock_info (id, code, name, rise_rate, rise_rate2, price1, price2, date)
VALUES
(1, '600000', '浦发银行', 1.25, 0.89, 8.56, 8.45, '2025-12-16'),
(2, '600036', '招商银行', 2.18, 1.56, 35.89, 35.12, '2025-12-16'),
(3, '000001', '平安银行', 0.98, 0.72, 12.35, 12.24, '2025-12-16'),
(4, '601318', '中国平安', 1.85, 1.21, 42.68, 41.95, '2025-12-16');

CREATE TABLE focus (
  id INT PRIMARY KEY AUTO_INCREMENT,
  note_info VARCHAR(50) COMMENT '备注信息',
  info_id INT COMMENT '关联的股票信息ID'
) COMMENT '关注表';

INSERT INTO focus (note_info, info_id)
VALUES
('重点关注银行股', 1),
('高成长性个股', 2),
('稳健型配置', 3),
('保险龙头标的', 4);

ALTER TABLE focus
ADD CONSTRAINT fk_focus_info_id
FOREIGN KEY (info_id) REFERENCES stock_info(id);

SELECT f.note_info, s.code, s.name, s.rise_rate
FROM focus f
LEFT JOIN stock_info s ON f.info_id = s.id;
framework.py代码
import time
import pymysql
"""web框架的职责,专门负责处理动态资源请求"""

# 路由列表,列表里面的每一条记录都是一个路由
route_list = [
    # ("/index.html", index),
    # ("/center.html", center),
    # ("/not_found.html", not_found),
]

# 定义一个带有参数的装饰器
def func_data(fand):
    # 装饰器
    def out(fn):
        # 当执行装饰器的时候,就需要把路由添加到路由列表里面
        # 当装饰函数的时候,只添加一次路由即可
        route_list.append((fand, fn))
        def inner():
            result = fn()
            return result
        return inner
    return out

# 获取首页数据
@func_data("/index.html")
def index():
    # 状态信息
    status = "200 OK"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # 打开指定的模板文件,读取模板文件中的数据
    with open("HTTP动态/index.html", "r",encoding='utf-8') as f:
        f_data = f.read()
    # 查询数据库,将数据库中的数据,把模板里的模板变量({% content %}),替换成数据库中的数据
    # 与数据库建立连接
    conn = pymysql.connect(
        host="192.168.10.128",
        port=3306,
        user="root",
        password="mysql",
        database="stock_db",
        charset="utf8",
    )
    # 获取游标
    cursor = conn.cursor()
    # 准备sql
    sql = "select * from stock_basic;"
    # 执行sql
    cursor.execute(sql)
    # 获取查询结果
    result = cursor.fetchall()
    print(result)
    # 关闭游标
    cursor.close()
    # 关闭连接
    conn.close()
    # 遍历每一条数据,完成数据tr标签的封装
    date = ""
    for row in result:
        date += """
            <table style="border: 1px solid black">
                <tr>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                </tr>
            </table>
        """ % row

    response_body = f_data.replace("{% content %}", date)
    # 这里返回的是元组
    return status, response_header, response_body

# 处理没有找到的动态资源
@func_data("/not_found.html")
def not_found():
    # 状态信息
    status = "404 Not Found"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # web框架处理后的数据
    date = "Not Found"
    # 这里返回的是元组
    return status, response_header, date

@func_data("/center.html")
def center():
    # 状态信息
    status = "200 OK"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # 打开指定的模板文件,读取模板文件中的数据
    with open("HTTP动态/center.html", "r", encoding='utf-8') as f:
        f_data = f.read()
    # 查询数据库,将数据库中的数据,把模板里的模板变量({% content %}),替换成数据库中的数据
    # 获取当前时间,模拟数据库内容
    date = time.ctime()  # 获取当前时间
    response_body = f_data.replace("{% content %}", date)
    # 这里返回的是元组
    return status, response_header, response_body

# 处理动态资源请求
def hande_request(evn):
    # 获取动态的请求资源路径
    request_path = evn["user_name"]
    # 遍历路由列表,匹配请求的url
    for path, func in route_list:
        if request_path == path:
            # 找到了指定路由,执行对应的处理函数
            result = func()
            return result
    else:
        # 没有这个页面,返回404页面
        result = not_found()
        return result

if __name__ == '__main__':
    # 测试装饰器是否成功添加路由
    print(route_list)
7.个人中心数据接口的开发
import time
import pymysql
import json
"""web框架的职责,专门负责处理动态资源请求"""

# 路由列表,列表里面的每一条记录都是一个路由
route_list = [
    # ("/index.html", index),
    # ("/center.html", center),
    # ("/not_found.html", not_found),
]

# 定义一个带有参数的装饰器
def func_data(fand):
    # 装饰器
    def out(fn):
        # 当执行装饰器的时候,就需要把路由添加到路由列表里面
        # 当装饰函数的时候,只添加一次路由即可
        route_list.append((fand, fn))
        def inner():
            result = fn()
            return result
        return inner
    return out

# 获取首页数据
@func_data("/index.html")
def index():
    # 状态信息
    status = "200 OK"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # 打开指定的模板文件,读取模板文件中的数据
    with open("HTTP动态/index.html", "r",encoding='utf-8') as f:
        f_data = f.read()
    # 查询数据库,将数据库中的数据,把模板里的模板变量({% content %}),替换成数据库中的数据
    # 与数据库建立连接
    conn = pymysql.connect(
        host="192.168.10.128",
        port=3306,
        user="root",
        password="mysql",
        database="stock_db",
        charset="utf8",
    )
    # 获取游标
    cursor = conn.cursor()
    # 准备sql
    sql = "select * from stock_info;"
    # 执行sql
    cursor.execute(sql)
    # 获取查询结果
    result = cursor.fetchall()
    # 关闭游标
    cursor.close()
    # 关闭连接
    conn.close()
    # 遍历每一条数据,完成数据tr标签的封装
    date = ""
    for row in result:
        date += """
            <table style="border: 1px solid black">
                <tr>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                </tr>
            </table>
        """ % row

    response_body = f_data.replace("{% content %}", date)
    # 这里返回的是元组
    return status, response_header, response_body

# 处理没有找到的动态资源
@func_data("/not_found.html")
def not_found():
    # 状态信息
    status = "404 Not Found"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # web框架处理后的数据
    date = "Not Found"
    # 这里返回的是元组
    return status, response_header, date

# 个人中心数据接口
@func_data("/center_data.html")
def center_data():
    # 从数据库把数据查询出来,然后把查询出来的数据转成json数据
    # 创建连接对象
    conn = pymysql.connect(
        host="192.168.10.128",
        port=3306,
        user="root",
        password="mysql",
        database="stock_db",
        charset="utf8",
    )
    # 创建游标
    cursor = conn.cursor()
    # 准备sql
    sql = """
        select s.code, s.name, s.rise_rate,s.rise_rate2, s.price1, s.price2, f.note_info
        from stock_info as s inner join focus as f
        on s.id = f.info_id;"""
    # 执行sql
    cursor.execute(sql)
    # 得到数据
    result = cursor.fetchall()
    print(result)
    # 将元组转成列表字典
    center_data_list = [{
                    "code":row[0],
                    "name":row[1],
                    "rise_rate":str(row[2]),
                    "rise_rate2":str(row[3]),
                    "price1":str(row[4]),
                    "price2":str(row[5]),
                    "note_info":row[6],
    } for row in result]
    print(center_data_list)
    # 将列表转成json字符串数据
    # ensure_ascii=False:取消使用ASCII解码,则能在控制台显示中文
    json_str = json.dumps(center_data_list, ensure_ascii=False)
    print(json_str)
    # 关闭游标
    cursor.close()
    # 关闭连接
    conn.close()
    status = "200 OK"
    # 响应头
    response_header = [
        ("Server", "PWS/1.1"),
        # 指定编码格式,因为没有模板文件,可以通过响应头指定编码格式
        ("Content-Type", "text/html;charset=utf-8")
    ]
    return status, response_header, json_str


@func_data("/center.html")
def center():
    # 状态信息
    status = "200 OK"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # 打开指定的模板文件,读取模板文件中的数据
    with open("HTTP动态/center.html", "r", encoding='utf-8') as f:
        f_data = f.read()
    # 查询数据库,将数据库中的数据,把模板里的模板变量({% content %}),替换成数据库中的数据
    date = time.ctime()
    response_body = f_data.replace("{% content %}", date)
    # 这里返回的是元组
    return status, response_header, response_body

# 处理动态资源请求
def hande_request(evn):
    # 获取动态的请求资源路径
    request_path = evn["user_name"]
    # 遍历路由列表,匹配请求的url
    for path, func in route_list:
        if request_path == path:
            # 找到了指定路由,执行对应的处理函数
            result = func()
            return result
    else:
        # 没有这个页面,返回404页面
        result = not_found()
        return result

if __name__ == '__main__':
    # 测试装饰器是否成功添加路由
    print(route_list)
    # 测试是否得到个人中心的数据
    center_data()
8.ajax请求数据渲染个人中心页面
cender.html代码
<!DOCTYPE html>
<html lang="zh-CN" xmlns="http://www.w3.org/1999/html" xmlns="http://www.w3.org/1999/html">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>个人中心</title>
    <style>
        * {
            margin: 0;
            padding: 0;
            box-sizing: border-box;
            font-family: Arial, sans-serif;
        }
        body {
            padding: 20px;
            background: #f8f8f8;
        }
        h1 {
            text-align: center;
            color: #333;
            margin-bottom: 30px;
        }
        .user-info {
            text-align: center;
            margin-bottom: 30px;
        }
        .user-info p {
            font-size: 16px;
            color: #666;
            margin-top: 10px;
        }
        .func-list {
            background: white;
            border-radius: 5px;
            padding: 10px;
        }
        .func-item {
            padding: 15px;
            border-bottom: 1px solid #eee;
        }
        .func-item:last-child {
            border: none;
        }
        .func-item a {
            text-decoration: none;
            color: #333;
            font-size: 16px;
        }
        .logout {
            display: block;
            width: 100%;
            padding: 12px;
            margin-top: 20px;
            border: none;
            background: #e64340;
            color: white;
            font-size: 16px;
            border-radius: 5px;
            cursor: pointer;
        }
        /* 动态内容区域样式 */
        .dynamic-content {
            margin: 20px 0;
            padding: 15px;
            background: white;
            border-radius: 5px;
            color: #333;
        }
    </style>
    <script src="jquery-1.12.4.min.js"></script>
    <script>
        $(document).ready(function () {
            $.get("center_data.html", function (data) {
                // ajax成功回调后的函数
                // 如果指定了返回数据的解析方式是json,那么data就是js对象
                // console.log(data);
                // 获取table标签
                var $table = $(".center_data");
                for(var i = 0; i < data.length; i++) {
                    // 根据下标获取每一个个人中心数据js对象
                    var oCenterData = data[i];
                    // 封装后的每一个表
                    var oTable = '<tr>' +
                                '<td>'+ oCenterData.code +'</td>' +
                                '<td>'+ oCenterData.name +'</td>' +
                                '<td>'+ oCenterData.rise_rate +'</td>' +
                                '<td>'+ oCenterData.rise_rate2 +'</td>' +
                                '<td>'+ oCenterData.price1 +'</td>' +
                                '<td>'+ oCenterData.price2 +'</td>' +
                                '<td>'+ oCenterData.note_info +'</td>' +
                                '</tr>'
                    $table.append(oTable);
                }
            },"json");
        })
    </script>
</head>
<body>
    <h1>个人中心</h1>

    <!-- 用户信息 -->
    <div class="user-info">
        <h2>用户名:张三</h2>
        <p>会员等级:普通会员</p>
    </div>
    <div class="func-list">
        <h3>已购产品</h3>
        <table class="center_data">

        </table>
    </div>

    <!-- 退出按钮 -->
    <button class="logout">退出登录</button>
</body>
</html>
9.logging日志
logging日志介绍
在现实生活中,记录日志非常重要,比如:银行转账时会有转账证录;飞机飞行过程中,会有个黑盒子(飞行数据记录器)记录着飞机的飞行过程,那在咱们python程序中想要记录程序在运行时所产生的日志信息,怎么做呢?
使用logging包来完成
记录程序日志信息的目的是:
- 可以很方便的了解程序的运行情况
- 可以分析用户的操作行为、喜好等信息
- 方便开发人员检查bug
logging日志级别介绍
日志等级可以分为5个,从低到高分别是:
- DEBUG
- INFO
- WARNING
- ERROR
- CRITICAL
日志等级说明:
- DEBUG:程序调试bug时使用
- INFO:程序正常运行时使用
- WARNING:程序未按预期运行时使用,但并不是错误,如:用户登录密码错误
- ERROR:程序未按预期运行时使用,如:IO操作失败
- CRITICAL:特别严重的问题,导致程序不能再继续运行时使用,如:磁盘空间为空,一般很少使用
- 默认的是WARNING等级,当WARNING或WARNING之上等级的才记录日志信息
- 日志等级从低到高的顺序是:DEBUG < INFO < WARNING < ERROR < CRITICAL
logging日志的使用
在 logging 包中记录日志的方式有两种:
- 输出到控制台
- 保存到日志文件
日志信息输出到控制台的示例代码:
import logging

logging.debug("这是一个debug级别的日志信息")
logging.info("这是一个info级别的日志信息")
logging.warning("这个是一个warning级别的日志信息")
logging.error("这个是一个error级别的日志信息")
logging.critical("这个是一个critical级别的日志信息")
运行结果:
WARNING:root:这个是一个warning级别的日志信息
ERROR:root:这个是一个error级别的日志信息
CRITICAL:root:这个是一个critical级别的日志信息
说明:
- 日志信息只显示了大于等于WARNING级别的日志,这说明默认的日志级别设置为WARNING
logging日志等级和输出格式的设置:
import logging

# 设置日志等级和输出日志格式
logging.basicConfig(level = logging.DEBUG,
                    format = '%(asctime)s-%(filename)s[lineno:%(lineno)d)]-%(levelname)s-%(message)s',
                    filename="log.txt",
                    filemode="w",   # 每次存入新的数据,不保留原数据
                    # filemode="a", # 每次增加新的数据,保留原数据
                    encoding = "utf-8", # 指定编码格式
                    )

logging.debug("这是一个debug级别的日志信息")
logging.info("这是一个info级别的日志信息")
logging.warning("这个是一个warning级别的日志信息")
logging.error("这个是一个error级别的日志信息")
logging.critical("这个是一个critical级别的日志信息")
level:表示设置级别format:表示设置输出格式%(asctime)s:获取当前时间%(filename)s:获取程序文件名[lineno:%(lineno)d)]:获取行号
%(levelname)s:获取logging日志级别%(message)s:获取日志内容
filename:表示日志输出的文件名encoding:指定编码格式
运行结果:
2025-12-16 19:18:40,862-测试.py[lineno:8)]-DEBUG-这是一个debug级别的日志信息
2025-12-16 19:18:40,863-测试.py[lineno:9)]-INFO-这是一个info级别的日志信息
2025-12-16 19:18:40,863-测试.py[lineno:10)]-WARNING-这个是一个warning级别的日志信息
2025-12-16 19:18:40,863-测试.py[lineno:11)]-ERROR-这个是一个error级别的日志信息
2025-12-16 19:18:40,863-测试.py[lineno:12)]-CRITICAL-这个是一个critical级别的日志信息
logging日志在mini-web项目中应用
web.py程序使用 logging 日志的设置
程序入口模块设置 logging 日志
import socket
import threading
import sys
import framework
import logging
# 在程序入口模块,设置logging日志的配置信息,只配置一次,整个程序都能使用,好比单例
# 设置日志等级和输出日志格式
logging.basicConfig(level = logging.DEBUG,
                    format = '%(asctime)s-%(filename)s[lineno:%(lineno)d)]-%(levelname)s-%(message)s',
                    filename="log.txt",
                    # filemode="w",   # 每次存入新的数据,不保留原数据
                    filemode="a", # 每次增加新的数据,保留原数据
                    encoding = "utf-8", # 指定编码格式
                    )

# HTTP协议的Web服务器类
class HttpWebServer(object):
    def __init__(self, port):
        server_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
        # 绑定端口
        server_socket.bind(('', port))
        # 设置端口复用
        server_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, True)
        # 设置监听(最大128位)
        server_socket.listen(128)
        # 把TCP服务器套接字作为web服务器对象属性
        self.server_socket = server_socket

    # 处理客户端请求
    @staticmethod
    # @staticmethod 是 Python 类中的静态方法装饰器,作用是定义一个与类和实例都无关的方法—— 它既不需要访问类属性,也不需要访问实例属性。
    def process(new, port):
        print(f'已与{port}建立连接')

        # 接收TCP客户端程序数据(最大4096字节)
        user_data = new.recv(4096)

        # 判断是否为空数据
        if len(user_data) == 0:
            print(f'{port}已下线...')
            new.close()
            return

        # 对客户端发送的数据进行转换
        user_data_info = user_data.decode("utf-8")
        # 对数据按照空格进行分割
        user_list = user_data_info.split(' ', maxsplit=2)
        # 获取请求路径
        user_name = user_list[1]

        if user_name == '/':
            # 指定路径
            user_name = '/index.html'

        # 判断是否是动态资源请求,以后把后缀.html的请求认为是动态资源请求
        if user_name.endswith(".html"):
            """动态资源请求"""
            logging.info(f"动态资源请求的地址:{user_name}")
            # 动态资源请求找web框架进行处理,需要把请求参数给web框架
            # 准备给web框架的参数信息,都要放在字典内
            env = {
                "user_name": user_name,
                # 传入请求头信息,额外的参数可以在字典里面再添加
            }
            # 1.使用框架处理动态资源请求,web框架需要把处理结果返回给web服务器
            # 2.web服务器负责把返回的结果封装成响应报文发送给浏览器
            # 状态信息,响应头信息,响应体信息
            status, headers, response_body = framework.hande_request(env)
            print(status, headers,response_body)
            # 响应行
            response_line = "HTTP/1.1 %srn" % status
            # 响应头
            response_header = ""
            for header in headers:
                response_header += "%s: %srn" % header
            # 响应报文
            response_date = (response_line +
                             response_header +
                             "rn" +
                             response_body).encode("utf-8")
            # 发送响应报文数据给浏览器
            new.send(response_date)
            # 关闭连接
            new.close()


        else:
            """静态资源请求"""
            logging.info(f"静态资源请求的地址:{user_name}")
            # 查看有无这个文件
            try:
                # 打开文件
                # 为了兼容图片使用rb打开
                with open(f"HTTP静态{user_name}", "rb") as file:  # file表示打开文件的对象
                    # with open 读取数据后关闭文件不需要程序员来完成,系统自己关闭
                    file_data = file.read()

            except Exception as e:
                # 到这里说明请求的没有该文件,返回404
                logging.warning("访问无效地址")
                # 响应行
                not_line = 'HTTP/1.1 404 Not Foundrn'
                # 响应头
                not_head = 'Server: PWS/1.0rn'
                with open("HTTP静态/404.html", "rb") as file:
                    not_file = file.read()

                not_info = (not_line + not_head + "rn").encode("utf-8") + not_file
                new.send(not_info)
            else:
                # 把数据封装成HTTP响应报文格式
                # 响应行
                line = 'HTTP/1.1 200 OKrn'
                # 响应头
                head = 'Server: PWS/1.0rn'
                # 响应体
                http_body = file_data
                # 合并
                rdr_info = (line + head + "rn").encode("utf-8") + http_body
                # 发送响应报文数据
                new.send(rdr_info)
            finally:
                # 断开连接
                new.close()
                print(f'{port}已下线...')

    # 启动服务器方法
    def start(self):
        while True:
            new, port = self.server_socket.accept()
            sub_process = threading.Thread(target=self.process, args=(new, port), daemon=True)
            sub_process.start()

def main():
    # 获取终端命令行参数
    parms = sys.argv

    if len(parms) != 2:
        print('格式错误!如下:')
        print('python xxx.py 端口号(数字)')
        logging.warning("在终端启动程序的参数不等于2")
        return

    # 判断第二个参数是否都是由数字组成
    if not parms[1].isdigit():
        print('格式错误!如下:')
        print('python xxx.py 端口号(数字)')
        logging.warning("在终端启动程序的类型不是数字字符串")
        return

    port = int(parms[1])
    print(f'成功!你的端口号是{port}')
    # 创建web服务器
    http = HttpWebServer(port)
    # 启动!!!
    http.start()

if __name__ == '__main__':
    main()
framework.py程序使用 logging 日志的设置
import pymysql
import json
import logging
"""web框架的职责,专门负责处理动态资源请求"""

# 路由列表,列表里面的每一条记录都是一个路由
route_list = [
    # ("/index.html", index),
    # ("/center.html", center),
    # ("/not_found.html", not_found),
]

# 定义一个带有参数的装饰器
def func_data(fand):
    # 装饰器
    def out(fn):
        # 当执行装饰器的时候,就需要把路由添加到路由列表里面
        # 当装饰函数的时候,只添加一次路由即可
        route_list.append((fand, fn))
        def inner():
            result = fn()
            return result
        return inner
    return out

# 获取首页数据
@func_data("/index.html")
def index():
    # 状态信息
    status = "200 OK"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # 打开指定的模板文件,读取模板文件中的数据
    with open("HTTP动态/index.html", "r",encoding='utf-8') as f:
        f_data = f.read()
    # 查询数据库,将数据库中的数据,把模板里的模板变量({% content %}),替换成数据库中的数据
    # 与数据库建立连接
    conn = pymysql.connect(
        host="192.168.10.128",
        port=3306,
        user="root",
        password="mysql",
        database="stock_db",
        charset="utf8",
    )
    # 获取游标
    cursor = conn.cursor()
    # 准备sql
    sql = "select * from stock_info;"
    # 执行sql
    cursor.execute(sql)
    # 获取查询结果
    result = cursor.fetchall()
    # 关闭游标
    cursor.close()
    # 关闭连接
    conn.close()
    # 遍历每一条数据,完成数据tr标签的封装
    date = ""
    for row in result:
        date += """
            <table style="border: 1px solid black">
                <tr>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                    <td>%s</td>
                </tr>
            </table>
        """ % row

    response_body = f_data.replace("{% content %}", date)
    # 这里返回的是元组
    return status, response_header, response_body

# 处理没有找到的动态资源
@func_data("/not_found.html")
def not_found():
    # 状态信息
    status = "404 Not Found"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # web框架处理后的数据
    date = "Not Found"
    # 这里返回的是元组
    return status, response_header, date

# 个人中心数据接口
@func_data("/center_data.html")
def center_data():
    # 从数据库把数据查询出来,然后把查询出来的数据转成json数据
    # 创建连接对象
    conn = pymysql.connect(
        host="192.168.10.128",
        port=3306,
        user="root",
        password="mysql",
        database="stock_db",
        charset="utf8",
    )
    # 创建游标
    cursor = conn.cursor()
    # 准备sql
    sql = """
        select s.code, s.name, s.rise_rate,s.rise_rate2, s.price1, s.price2, f.note_info
        from stock_info as s inner join focus as f
        on s.id = f.info_id;"""
    # 执行sql
    cursor.execute(sql)
    # 得到数据
    result = cursor.fetchall()
    # print(result)
    # 将元组转成列表字典
    center_data_list = [{
                    "code":row[0],
                    "name":row[1],
                    "rise_rate":str(row[2]),
                    "rise_rate2":str(row[3]),
                    "price1":str(row[4]),
                    "price2":str(row[5]),
                    "note_info":row[6],
    } for row in result]
    # print(center_data_list)
    # 将列表转成json字符串数据
    # ensure_ascii=False:取消使用ASCII解码,则能在控制台显示中文
    json_str = json.dumps(center_data_list, ensure_ascii=False)
    print(json_str)
    # 关闭游标
    cursor.close()
    # 关闭连接
    conn.close()
    status = "200 OK"
    # 响应头
    response_header = [
        ("Server", "PWS/1.1"),
        # 指定编码格式,因为没有模板文件,可以通过响应头指定编码格式
        ("Content-Type", "text/html;charset=utf-8")
    ]
    return status, response_header, json_str


@func_data("/center.html")
def center():
    # 状态信息
    status = "200 OK"
    # 响应头
    response_header = [("Server", "PWS/1.1")]
    # 打开指定的模板文件,读取模板文件中的数据
    with open("HTTP动态/center.html", "r", encoding='utf-8') as f:
        f_data = f.read()

    response_body = f_data.replace("{% content %}", "")
    # 这里返回的是元组
    return status, response_header, response_body

# 处理动态资源请求
def hande_request(evn):
    # 获取动态的请求资源路径
    request_path = evn["user_name"]
    # 遍历路由列表,匹配请求的url
    for path, func in route_list:
        if request_path == path:
            # 找到了指定路由,执行对应的处理函数
            result = func()
            return result
    else:
        # 没有这个页面,返回404页面
        result = not_found()
        logging.error(f"没有设置相关的路由信息:{request_path}")
        return result

if __name__ == '__main__':
    # 测试装饰器是否成功添加路由
    print(route_list)
    # 测试是否得到个人中心的数据
    center_data()
二十六、正则表达式
1.property属性
property属性的介绍
property属性就是负责把一个方法当做属性进行使用,这样做可以简化代码
定义property属性有两种方式
- 装饰器方式
- 类属性方式
装饰器方式
class Student(object):
    def __init__(self):
        # 定义私有属性age
        self.__age = 0

    @property   # 当对象调用age属性的时候,会执行下面的方法
    def age(self):
        print("获取属性")
        return self.__age

    @age.setter     # 当对象调用age属性设置值的时候,会调用下面的方法
    def age(self, new_age):
        print("设置属性")
        if new_age >= 0 and new_age <= 100:
            self.__age = new_age
        else:
            print("成精了?")


student = Student()
age = student.age
print(age)
student.age = 37
age = student.age
print(age)
注:使用装饰器方式的 property 属性,那么方法名保持一致
类属性方式
class Student(object):
    def __init__(self):
        # 定义私有属性age
        self.__age = 0

    def get_age(self):
        print("获取属性")
        return self.__age

    def set_age(self, new_age):
        print("设置属性")
        if new_age >= 0 and new_age <= 100:
            self.__age = new_age
        else:
            print("成精了?")

    # get_age:表示获取age属性时执行的方法
    # set_age:表示设置age属性时执行的方法
    age = property(get_age, set_age)


student = Student()
age = student.age
print(age)
student.age = 37
age = student.age
print(age)
2.with语句和上下文管理器
with语句的使用
基础版本向文件中写入数据的示例:
# 以写的方式打开文件
f = open("1.txt","w")
# 写入文件内容
f.write("hello world")
# 关闭文件
f.close()
说明:
- 文件使用完后必须关闭,因为文件对象会占有操作系统的资源,并且操作系统同一时间能打开的文件数量也是有限的
这种写法存在一定的错误,如下:
# 以只读的方式打开
f = open("log.txt", "r")
# 写入数据
f.write("hello")
print("over")
# 关闭文件
f.close()
这时候程序无法运行并报错,且文件无法释放继续占用系统缓存,需要添加异常:
try:
    # 以只读的方式打开
    f = open("log.txt", "r")
    # 写入数据
    f.write("hello")
except Exception as e:
    print(e)
finally:
    print("over")
    # 关闭文件
    f.close()
with语句既简单又安全,并且with语句执行完成后自动调用关闭文件操作,即使出现异常也会自动调用关闭文件操作
示例:
with open("log.txt","r") as f:
    f_data = f.read()
    # 写入文件时,即使会报错,也会关闭文件
    # f.write("aaaa")
    print(f_data)
上下文管理器
一个类只要实现了__enter__()和__exit__()这两个方法,通过该类创建的对象我们就称之为上下管理器
上下文管理器可以使用 with 语句,with 语句之所以那么强大,背后是由上下文管理器做支撑的,也就是说上面使用 open 函数创建文件对象就是一个上下文管理器对象
自定义上下文管理器类,模拟文件操作
定义一个 File 类,实现__enter__()和__exit__()方法,使用 with 语句来完成操作文件,示例:
# 自定义上下文管理器类
class File(object):
    # 初始化方法
    def __init__(self, file_name, file_mode):
        # 文件名
        self.file_name = file_name
        # 文件的打开方式
        self.file_mode = file_mode

    # 上文方法,负责返回操作对象资源,比如文件对象,数据库连接对象
    def __enter__(self):
        print("执行上文方法")
        self.file = open(self.file_name, self.file_mode)
        return self.file

    # 当 with 语句执行完成以后,自动执行 __exit__()方法
    # 下文方法,负责释放对象资源,关闭文件,关闭数据库连接对象
    def __exit__(self, exc_type, exc_val, exc_tb):
        print("执行下文方法")
        self.file.close()

if __name__ == '__main__':
    # with 语句结合上下文管理器对象使用
    with File("log.txt", "r") as f:
        file_data = f.read()
        print(file_data)
        # f.write("hhh")
上下文管理器的另外一种实现方式
假如想让一个函数称为上下文管理器,Python 还提供了一个@contextmanager的装饰器,更进一步简化了上下文管理器的实现方式,通过 yield 将函数分割成两部分,yield 上面的语句在__enter__方法中执行,yield 下面的语句在__exit__方法中执行,紧跟在 yield 后面的参数是函数的返回值
# 导入模块
from contextlib import contextmanager

# 加上装饰器这个代码,那么下面函数创建的对象就是一个上下文管理器
@contextmanager
def my_open(file_name, file_mode):
    try:
        file = open(file_name, file_mode)
        # yield 关键字之前的代码可以认为是上文方法,负责返回操作对象资源
        yield file
    except Exception as e:
        print(e)
    finally:
        # yield 关键字之后的代码可以认为是下文方法,负责释放操作对象的资源
        print("over")
        file.close()

# 普通函数不能结合with语句使用,with语句结合上下文管理器使用
with my_open("log.txt", "r") as f:
    file_data = f.read()
    print(file_data)
3.生成器的创建方式
生成器的介绍
根据程序员制定的规则循环生成数据,当条件不成立时,则生成数据结束,数据不是一次性全部生成处理,而是使用一个,再生成一个,可以节约大量的内存
创建生成器的方法
- 生成器推导式
yield关键字
生成器推导式
- 与列表推导式类似,只不过生成器推导式使用小括号
# 生成器推导式
my_generator = (x*2 for x in range(3))
print(my_generator)

# 生成器取值使用next函数获取生成器中的下一个值
# 方法一
# # 取第一个值
# value = next(my_generator)
# print(value)
# # 取第二个值
# value = next(my_generator)
# print(value)
# # 取第三个值
# value = next(my_generator)
# print(value)
# # 当生成器没有值时,会抛出StopIteration,表示生成器生成数据完毕
# value = next(my_generator)
# print(value)

# 方法二
# while True:
#     try:
#         value = next(my_generator)
#         print(value)
#     except StopIteration as e:
#         # 跳出循环表示取值完成
#         break

# 方法三
# for循环内部调用next函数获取生成器中的下一个值,当出现异常for循环内部自动进行了异常捕获
for value in my_generator:
    print(value)
yield关键字
# yield 关键字
# 在函数内看到有yield关键字,那么这个函数就是一个生成器
def my_generator():
    for i in range(3):
        print('开始生成数据...')
        # 当程序执行到yield关键字的时候,代码会暂停并把结果返回,再次启动生成器的时候,会在暂停的位置继续往下执行
        yield i
        print('生成完成...')

result = my_generator()
print(result)

# 获取生成器下一个值
# value = next(result)
# print(value)
# value = next(result)
# print(value)
# value = next(result)
# print(value)

for value in result:
    print(value)
说明:
next函数:获取生成器中下一个值
生成器的使用场景
数学中有个著名的斐波那契数列(Fibonacci),数列中的第一个数为0,第二个数为1,其后的每个数都可以由前两个数相加得到:
0,1,1,2,3,5,8,13.21.34,...
现在我们使用生成器来实现这个斐波那契数列,每次取值都通过算法来生成下一个数据,生成器每次调用只生成一个数据,可以节省大量内存
# num 表示生成斐波那契数列的个数
def fibonacci(num):
    # 初始化前两个值
    a = 0
    b = 1
    # 记录每次生成数据个数的索引
    current_index = 0
    # 循环判断条件是否成立
    while current_index < num:
        result = a
        # 条件成立,交换两个变量的值
        a, b = b, a + b
        current_index += 1
        yield result

# 创建生成器
values = fibonacci(9)
for value in values:
    print(value)
4.深拷贝和浅拷贝
浅拷贝
copy函数是浅拷贝,只对可变类型的第一层对象进行拷贝,对拷贝的对象开辟新的内存空间进行存储,不会拷贝对象内部的子对象
不可变类型的浅拷贝示例:
# 导入模块
import copy
# 不可变类型:数字、字符串、元组

num1 = 1

# copy()表示是一个浅拷贝函数
# 浅拷贝
num2 = copy.copy(num1)
# 查看后,内存地址没有发生变化,说明没有对对象进行拷贝,也就是说没有开辟新的内存空间
print("num1:", id(num1),"num2:", id(num2))
# 对不可变类型进行浅拷贝,实际上是对引用的一个拷贝,两个变量指向同一个内存地址

my_tuple1 = (1,2)
my_tuple2 = copy.copy(my_tuple1)
print("my_tuple:", id(my_tuple1),"my_tuple2:", id(my_tuple2))
结果:
num1: 140713757680760 num2: 140713757680760
my_tuple1: 2254377987328 my_tuple2: 2254377987328
结论:
- 浅拷贝不会对不可变类型进行拷贝,也就是说不会开辟新的内存空间
可变类型的浅拷贝示例:
# 导入模块
import copy
# 可变类型:列表、字典、集合
my_list1 = [1,99,[2,3,4]]
my_list2 = copy.copy(my_list1)
print("my_list1:",id(my_list1),"my_list2:",id(my_list2))
my_list1.append(100)
print("my_list1 = ",my_list1)
print("my_list2 = ",my_list2)

# 子元素指向同一内存地址
print("my_list1[2]:",id(my_list1[2]),"my_list2[2]",id(my_list2[2]))
my_list1[2].append(6)
print("my_list1 = ",my_list1)
print("my_list2 = ",my_list2)
结果:
my_list1: 2119685538240 my_list2: 2119686127872
my_list1 =  [1, 99, [2, 3, 4], 100]
my_list2 =  [1, 99, [2, 3, 4]]
my_list1[2]: 2119684650432 my_list2[2] 2119684650432
my_list1 =  [1, 99, [2, 3, 4, 6], 100]
my_list2 =  [1, 99, [2, 3, 4, 6]]
可变类型的浅拷贝说明:
- 通过上面的执行结果可以得知,可变类型进行浅拷贝只对可变类型的第一层对象进行拷贝,对拷贝的对象会开辟新的内存空间进行存储,子对象不进行拷贝
深拷贝
deepcopy函数是深拷贝,只要发现对象有可变类型就会对该对象到最后一个可变类型的每一层对象进行拷贝,对每一层拷贝的对象都会开辟新的内存空间进行存储
不可变类型的深拷贝示例:
# 导入模块
import copy

# 不可变类型:数字、字符串、元组(内部不包含可变类型元素)
num1 = 2
num2 = copy.deepcopy(num1)
print("num1:", id(num1))
print("num2:", id(num2))

str1 = "hello"
str2 = copy.deepcopy(str1)
print("str1:", id(str1))
print("str2:", id(str2))

# 元组内不包含可变类型
tuple1 = (1, 2, 5)
tuple2 = copy.deepcopy(tuple1)
print("tuple1:", id(tuple1))
print("tuple2:", id(tuple2))

# 元组内包含可变类型
tuple3 = (1, 2, [1,2,3,4,5])
tuple4 = copy.deepcopy(tuple3)
print("tuple3:", id(tuple3))
print("tuple4:", id(tuple4))
tuple3[2].append(6)
print("tuple3 = ",tuple3)
print("tuple4 = ",tuple4)
# 其中列表内存地址
print("tuple3_list:", id(tuple3[2]))
print("tuple4_list:", id(tuple4[2]))
# 其中1的内存地址
print("tuple3_tuple:", id(tuple3[1]))
print("tuple4_tuple:", id(tuple4[1]))
结果:
num1: 140713757680792
num2: 140713757680792
str1: 2405597593296
str2: 2405597593296
tuple1: 2405327734960
tuple2: 2405327734960
tuple3: 2405608245264
tuple4: 2405597714032
tuple3 =  (1, 2, [1, 2, 3, 4, 5, 6])
tuple4 =  (1, 2, [1, 2, 3, 4, 5])
tuple3_list: 2405320619456
tuple4_list: 2405322096896
tuple3_tuple: 140713757680792
tuple4_tuple: 140713757680792
注:
- 不可变类型一般不拷贝(拷贝没有意义)
- 元组内的数据,如
(1, [1,2])- 其中
1和拷贝后的1内存空间地址相同 - 子对象
[1,2]拷贝后的内存空间地址不同
- 其中
可变类型的深拷贝示例:
# 导入模块
import copy

# 可变类型:列表、字典、集合
list1 = [1,2,[3,4]]
list2 = copy.deepcopy(list1)
print('list1:',id(list1))
print('list2:',id(list2))
# 子对象的内存空间地址
print('list1子对象:',id(list1[2]))
print('list2子对象:',id(list2[2]))
结果:
list1: 1595591852480
list2: 1595592442112
list1子元素: 1595590833600
list2子元素: 1595592068800
深拷贝和浅拷贝的区别:
- 浅拷贝最多拷贝对象的一层
- 深拷贝可以拷贝对象的多层
5.正则表达式的概述
正则表达式的介绍
在实际开发过程中,经常会有查找符合某些负责规则的字符串的需要,比如:邮箱、图片、手机号码等,这个时候想匹配或者查找符合某些规则的字符串就可以使用正则表达式了
正则表达式概念
正则表达式就是记录文本规则的代码
正则表达式的样子
0d{2}-d{8}这个就是一个正则表达式,表达的意思是匹配的座机号码
正则表达式的特点
- 正则表达式的语法很令人头疼,可读性差
- 正则表达式通用性很强,能够适用于很多编程语言
总结
- 正则表达式是匹配符合某些规则的字符串数据
6.re的模块介绍
re模块的介绍
在Python中需要通过正则表达式对字符串进行匹配时,可以使用一个re模块
re模块的使用
import re

# 根据正则表达式匹配数据
# 第一个参数:正则表达式
# 第二个参数:要匹配的字符串
# 返回匹配对象
match_ojb = re.match("hel","hello")
# 获取匹配结果
result = match_ojb.group()
print(result)
运行结果:
hel
总结:
re.match():根据正则表达式从头开始匹配字符串数据
7.匹配单个字符
匹配单个字符
| 代码 | 功能 |
|---|---|
. |
匹配任意一个字符(除了n) |
[] |
匹配[]中列举的字符 |
d |
匹配数字,即0 – 9 |
D |
匹配非数字,即不是数字 |
s |
匹配空白,即空格、tab键(t) |
S |
匹配非空白 |
w |
匹配非特殊字符,即a-z、A-Z、0-9、_、汉字 |
W |
匹配特殊字符,即非字母、非数字、非汉字、非下划线 |
示例:
import re

# . :匹配任意一个字符(除了`n`)
match_obj = re.match("t.o","two")
# match_obj为非空就执行下面的代码
if match_obj:
    # 获取匹配结果
    result = match_obj.group()
    print(result)
else:
    # 匹配失败,那么match_obj=None
    print("匹配失败...")


# []:匹配`[]`中列举的字符
match_obj = re.match("葫芦娃[1234]","葫芦娃2")
# match_obj为非空就执行下面的代码
if match_obj:
    # 获取匹配结果
    result = match_obj.group()
    print(result)
else:
    # 匹配失败,那么match_obj=None
    print("匹配失败...")


# d:匹配数字,即0 - 9
# 匹配银行卡密码中的其中一位】
# 写法1
# match_obj = re.match("[0123456789]","7")
# 写法2
# match_obj = re.match("[0-9]","7")
match_obj = re.match("\d","7")  # SyntaxWarning异常
# match_obj = re.match("\d","7")   # 不会提示报错
# match_obj为非空就执行下面的代码
if match_obj:
    # 获取匹配结果
    result = match_obj.group()
    print(result)
else:
    # 匹配失败,那么match_obj=None
    print("匹配失败...")


# D:匹配非数字,即不是数字
# match_obj = re.match("D","7")  # SyntaxWarning异常
match_obj = re.match("\D","7")   # 不会提示报错
# match_obj为非空就执行下面的代码
if match_obj:
    # 获取匹配结果
    result = match_obj.group()
    print(result)
else:
    # 匹配失败,那么match_obj=None
    print("匹配失败...")


# s:匹配空白,即空格、tab键(t)
# match_obj = re.match("葫芦娃sd","葫芦娃 1")  # SyntaxWarning异常
match_obj = re.match("葫芦娃\s\d","葫芦娃 1")   # 不会提示报错
# match_obj为非空就执行下面的代码
if match_obj:
    # 获取匹配结果
    result = match_obj.group()
    print(result)
else:
    # 匹配失败,那么match_obj=None
    print("匹配失败...")


# S:匹配非空白
match_obj = re.match("葫芦娃\S\d","葫芦娃 1")   # 不会提示报错
# match_obj为非空就执行下面的代码
if match_obj:
    # 获取匹配结果
    result = match_obj.group()
    print(result)
else:
    # 匹配失败,那么match_obj=None
    print("匹配失败...")


# w:匹配非特殊字符,即a-z、A-Z、0-9、_、汉字
# 匹配某网站中密码中的其中一位:密码是由字母、数字、下划线组成
# match_obj = re.match("w","_")  # SyntaxWarning异常
match_obj = re.match("\w","_")   # 不会提示报错
# match_obj为非空就执行下面的代码
if match_obj:
    # 获取匹配结果
    result = match_obj.group()
    print(result)
else:
    # 匹配失败,那么match_obj=None
    print("匹配失败...")


# W:匹配特殊字符,即非字母、非数字、非汉字、非下划线
# match_obj = re.match("W","%")  # SyntaxWarning异常
match_obj = re.match("\W","%")   # 不会提示报错
# match_obj为非空就执行下面的代码
if match_obj:
    # 获取匹配结果
    result = match_obj.group()
    print(result)
else:
    # 匹配失败,那么match_obj=None
    print("匹配失败...")
8.匹配多个字符
| 代码 | 功能 |
|---|---|
* |
匹配前一个字符出现0次或者无限次,即可有可无 |
+ |
匹配前一个字符出现1次或者无限次,即至少有1次 |
? |
匹配前一个字符出现0次或者1次,即要么有一次,要么没有 |
{m} |
匹配前一个字符出现m次 |
{m,n} |
匹配前一个字符出现从m到n次 |
示例:
import re

# *:匹配前一个字符出现0次或者无限次,即可有可无
# match_obj = re.match("tw*o", "twwwwwwwo")
match_obj = re.match("t.*o", "tsfddfdo")
# match_obj = re.match("t.*o", "to")
if match_obj:
    result = match_obj.group()
    print(result)
else:
    print("匹配失败...")


# +:匹配前一个字符出现1次或者无限次,即至少有1次
match_obj = re.match("t.+o", "to")
if match_obj:
    result = match_obj.group()
    print(result)
else:
    print("匹配失败...")


# ?:匹配前一个字符出现0次或者1次,即要么有一次,要么没有
# match_obj = re.match("https?", "http")
match_obj = re.match("https?", "https")
if match_obj:
    result = match_obj.group()
    print(result)
else:
    print("匹配失败...")


# {m}:匹配前一个字符出现m次
# match_obj = re.match("ht{2}ps?", "http")
# match_obj = re.match("ht{2}ps?", "htttps")
match_obj = re.match("ht{2}ps?", "https")
if match_obj:
    result = match_obj.group()
    print(result)
else:
    print("匹配失败...")


# {m,n}:匹配前一个字符出现从m到n次
match_obj = re.match("ht{1,3}ps?", "htttps")
if match_obj:
    result = match_obj.group()
    print(result)
else:
    print("匹配失败...")
# 扩展:{m,n}中,当n不指定时,表示从m到无限次
9.匹配开头和结尾
匹配开头和结尾
| 代码 | 功能 |
|---|---|
^ |
匹配字符串开头 |
$ |
匹配字符串结尾 |
示例:
import re

# ^:匹配字符串开头
match_ojb = re.match("^\d.*","1abc")
if match_ojb:
    result = match_ojb.group()
    print(result)
else:
    print("匹配失败...")

# $:匹配字符串结尾
match_ojb = re.match(".*\d$","abc1")
if match_ojb:
    result = match_ojb.group()
    print(result)
else:
    print("匹配失败...")

# 开头数字,结尾数字
match_ojb = re.match("^\d.*\d$","2我的abc1")
if match_ojb:
    result = match_ojb.group()
    print(result)
else:
    print("匹配失败...")
除了指定字符以外都匹配
[^指定字符]:表示除了指定字符都匹配
需求:第一个字符除了 aeiou 的字符都匹配
import re

match_ojb = re.match("[^aeiou]","hello")
if match_ojb:
    result = match_ojb.group()
    print(result)
else:
    print("匹配失败...")
结果:
h
10.匹配分组
匹配分组正则表达式
| 代码 | 功能 |
|---|---|
| ` | ` |
(ab) |
将括号中的字符作为一个分组 |
num |
引用分组num匹配到字符串 |
(?P<name>) |
分组起别名 |
(?P=name) |
引用别名为name分组匹配到字符串 |
示例:
import re

# 水果列表
fruit_list = ["apple", "banana", "cherry","orange", "strawberry", "peach"]

# | :匹配左右任意一个表达式
for value in fruit_list:
    # 根据每一个字符串,使用正则表达式进行匹配
    match_ojb = re.match("banana|strawberry", value)
    if match_ojb:
        result = match_ojb.group()
        print("我想吃的水果:",result)
    else:
        print(f"我不想吃的水果:{value}")
示例:
需求:匹配出,163、126、qq等邮箱
import re
# 匹配出,163、126、qq等邮箱
# \. 表示对正则表达式里面的点进行转义,变成了普通的字符串,只能匹配.字符
# (163|126|qq) 小括号里面表示分组,出现一个小括号就表示一个分组,分组是从1开始的
# 如果出现多个小括号,分组的顺序是从左到右依次排序
match_ojb = re.match("[a-zA-Z0-9_]{4,20}@(163|126|qq)\.com", "hello@126.com")
if match_ojb:
    # 获取整个匹配数据,如果使用分组数的话,默认是0
    result = match_ojb.group(0)
    # 获取第一个分组匹配的数据
    # result = match_ojb.group(1)
    print(result)
else:
    print("匹配失败...")
示例:
需求:qq:30128743只取其中一部分
import re

match_ojb = re.match("qq:([1-9]\d{4,11})", "qq:30128743")
if match_ojb:
    # 获取整个匹配数据,如果使用分组数的话,默认是0
    result = match_ojb.group()
    print(result)

    result = match_ojb.group(1)
    print(result)
else:
    print("匹配失败...")
示例:num
需求:匹配出<html>hhhh</html>
import re

# match_ojb = re.match("<[a-zA-Z1-6]+>.*</[a-zA-Z1-6]+>", "<html>hhhh</div>")
# 想使前后标签内容一致,可以使用num
match_ojb = re.match("<([a-zA-Z1-6]+)>.*</\1>", "<html>hhhh</html>")
if match_ojb:
    result = match_ojb.group()
    print(result)
else:
    print("匹配失败...")
示例:
使用(?P<name>)给分组起别名且使用(?P=name)引用别名为name分组匹配到字符串
import re

match_ojb = re.match("<(?P<name1>[a-zA-Z1-6]+)>.*</(?P=name1)>", "<html>hhhh</html>")
if match_ojb:
    result = match_ojb.group()
    print(result)
else:
    print("匹配失败...")

如有错误,请反馈给作者,谢谢🌹